成绩组成 4:6
C1 绪论
数据库的基本概念
-
⭐数据库、DBMS、数据库系统
概念 含义 数据库 DB 长期存储、有组织、可共享的大量数据的集合 数据库管理系统 DBMS 管理数据库的软件,位于应用程序和数据库之间(如 MySQL、Oracle、SQLSever) **数据库系统 DBS ** 数据库、DBMS、应用程序、数据库管理员、硬件等构成的整体 数据库应用系统 面向具体业务开发的应用程序及其数据库环境 = 数据库 + DBMS + 应用程序 + 数据库管理员 +硬件环境 -
⭐文件系统 vs 数据库
对比角度 文件方式 数据库方式 分散/统一 数据分散在不同文件 数据统一组织和管理 共享 共享困难 支持多用户共享 冗余 冗余较多 可以控制冗余 耦合/独立 程序与数据耦合较强 具有数据独立性 性质 一致性、安全性难保证 DBMS 统一保证完整性、安全和并发 适用场景 适合简单、独立的小规模数据 适合长期、共享、结构化业务数据 -
数据管理技术的产生和发展:人工管理阶段 → 文件系统阶段 → 数据库系统阶段
-
数据库系统的特点
- 数据结构化
- 数据共享性高,冗余度低、易扩充
- 数据独立性高
- 数据由数据库管理系统 统一管理和控制
数据模型的组成要素 & 常用数据模型
 —>
数据库的三级模式
- 从数据库应用开发人员角度看,数据库通常采用 三级模式结构
层次 描述内容 外模式 某一类用户看到的局部数据,也叫用户视图 模式/概念模式 整个数据库的全局逻辑结构 内模式 数据的物理存储结构、文件组织和存取路径 
两种数据独立性
- 逻辑数据独立性:概念模式改变时,外模式和应用程序尽量不用改变。
例如增加一个属性,只需调整外模式与概念模式之间的映像,原有应用仍可使用原来的视图。 - 物理数据独立性:内模式改变时,概念模式和应用程序不用改变。
例如把顺序文件改成 B+ 树索引,应用程序仍然执行相同的 SQL。
C2 关系数据库
关系数据结构
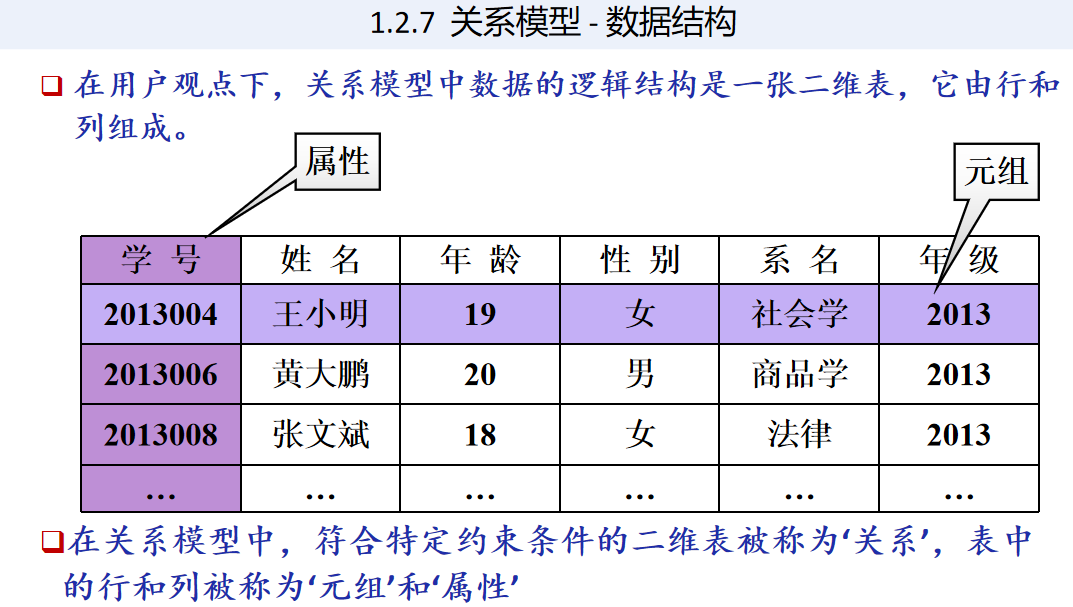
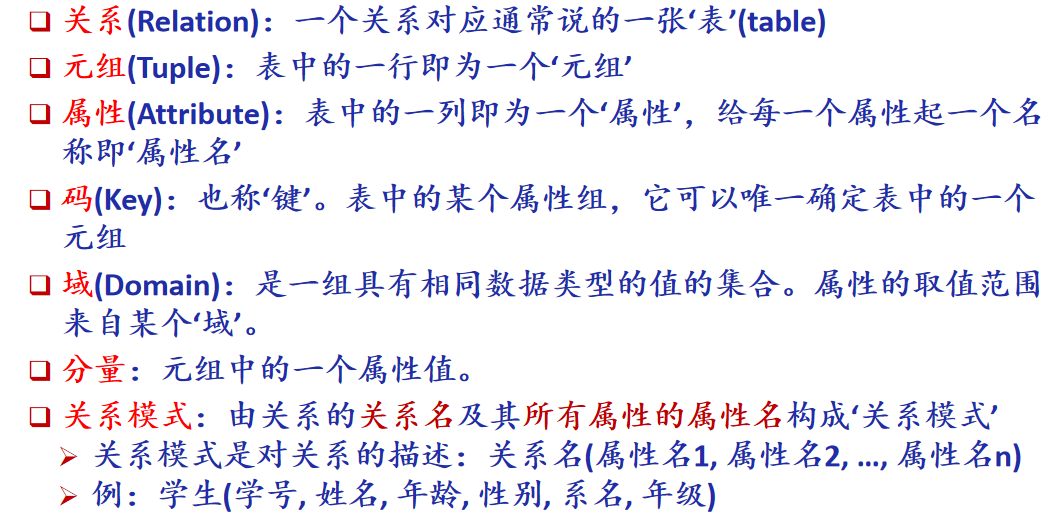
- 关系
- 关系模型只有单一的数据结构:关系;
关系模型的逻辑结构:二维表 - 关系:在域 上的关系 也是一个 元有序组的集合,
并且是其笛卡尔积的一个 子集:
- 属性:二维表中的 每一列,被称为是该关系中的一个‘属性’
- 元组 tuple:二维表中的 每一行,,表示元组t在属性 上的取值; 表示元组t在第i列上的取值。如:(李敏君,软件工程专业,19)
- 分量:元组中的每一个值叫做一个分量.如:李敏君、软件工程专业、19
元组连接:上弧线,表示把两个表连接起来。 - 基数:一个域允许的不同取值个数
- 关系的表示:在域 上的关系R可以被表示为
其中 是属性名 eg:“专业”
- 域
相同数据类型的值的集合,域内元素互不相同。如:整数集合、{男,女}、char (25) 字符串集合 - (候选)码 Key
若关系中的某一 属性组 的值能唯一地标识一个元组,而其所有的真子集都不能,则称该 属性组 为关系的 ‘候选码’ ,简称 ‘码’ - 主码:
- 全码 All-key:关系中的所有属性构成的属性组是这个关系的候选码,称为 ‘全码’(All-key)
- 主属性 与 非主属性/非码属性
- 候选码中的诸属性称为该关系的 ‘主属性’(Prime attribute)
- 不包含在任何侯选码中的属性称为该关系的 ‘非主属性’/‘非码属性’
- 关系模型只有单一的数据结构:关系;
⭐关系的完整性约束
- 实体完整性
主码属性不能为空 NULL - 参照完整性
- 外码值要么为空,要么等于被参照关系的主码值
- 外码:
参照关系:R(拿着外码的表,比如学生表)
被参照关系:S(被引用主键的表,比如专业表)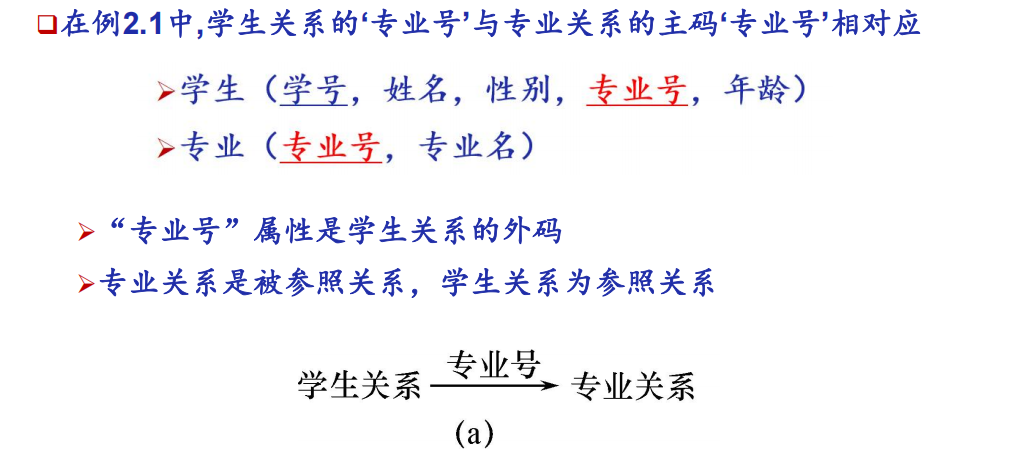
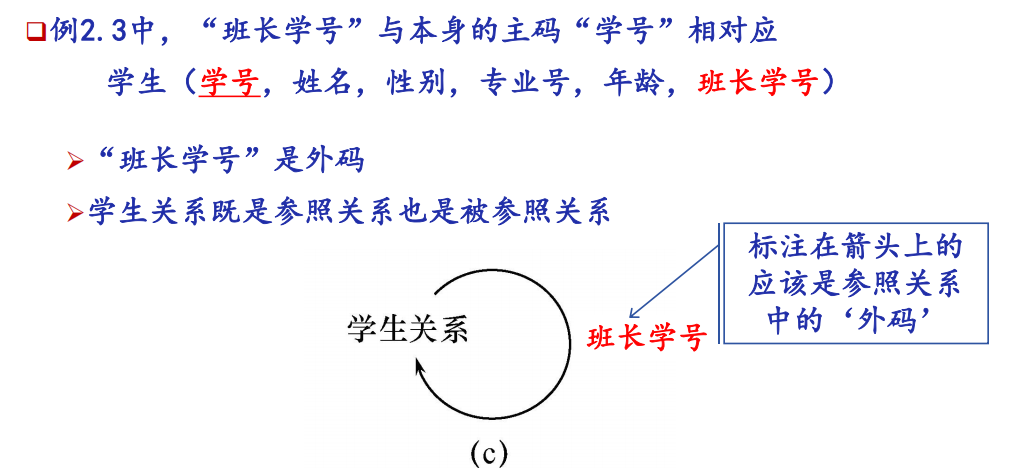
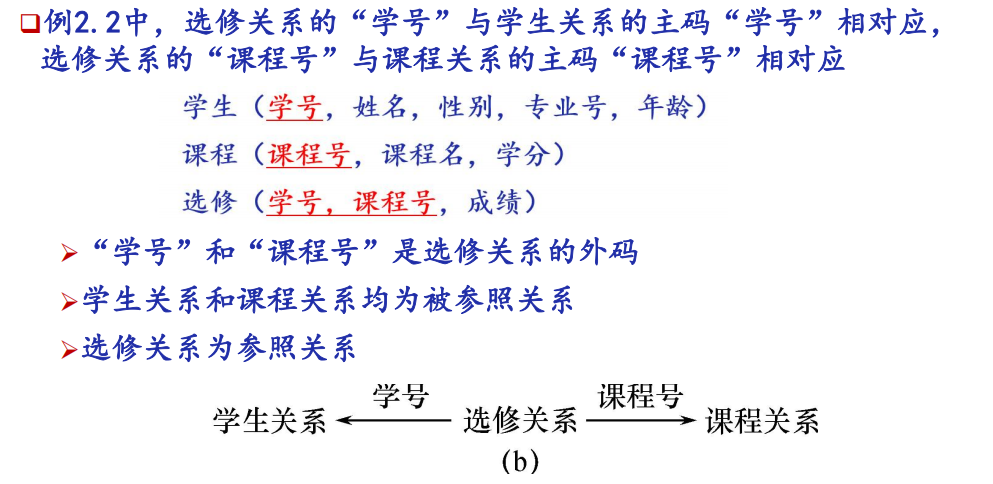
- 用户定义的完整性
⭐关系代数
-
关系运算
 选择:、投影:
-
例
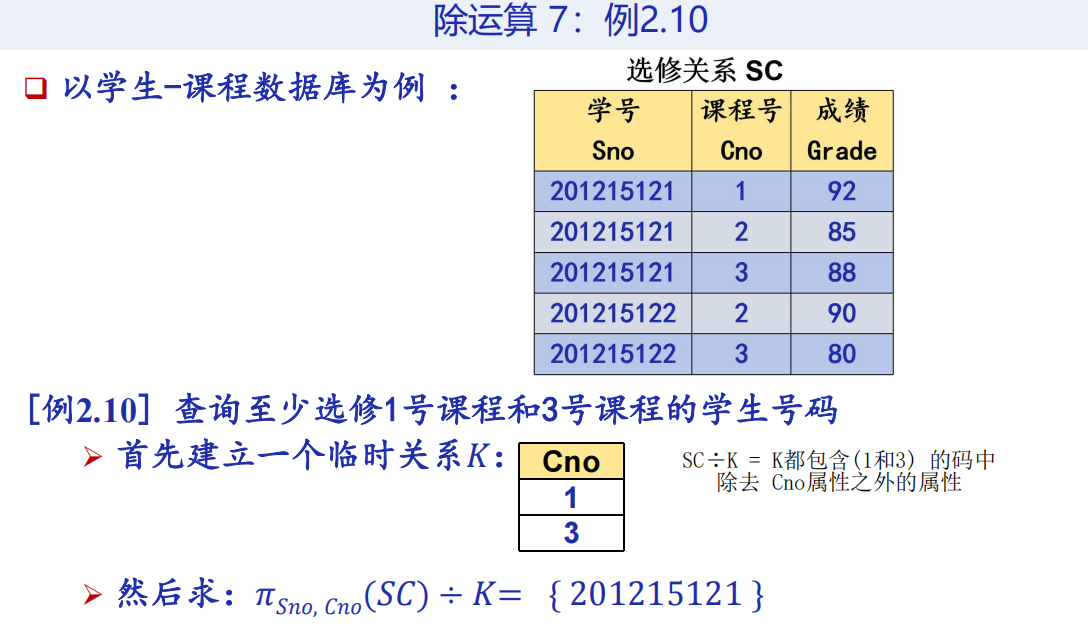
- 所有:除运算÷;只:


- 所有:除运算÷;只:
-
最大/最高 在当前的所有顾客中, 查询折扣(discnt)最高的顾客的编号?
令 , “折扣不是最高的顾客的id”
答案是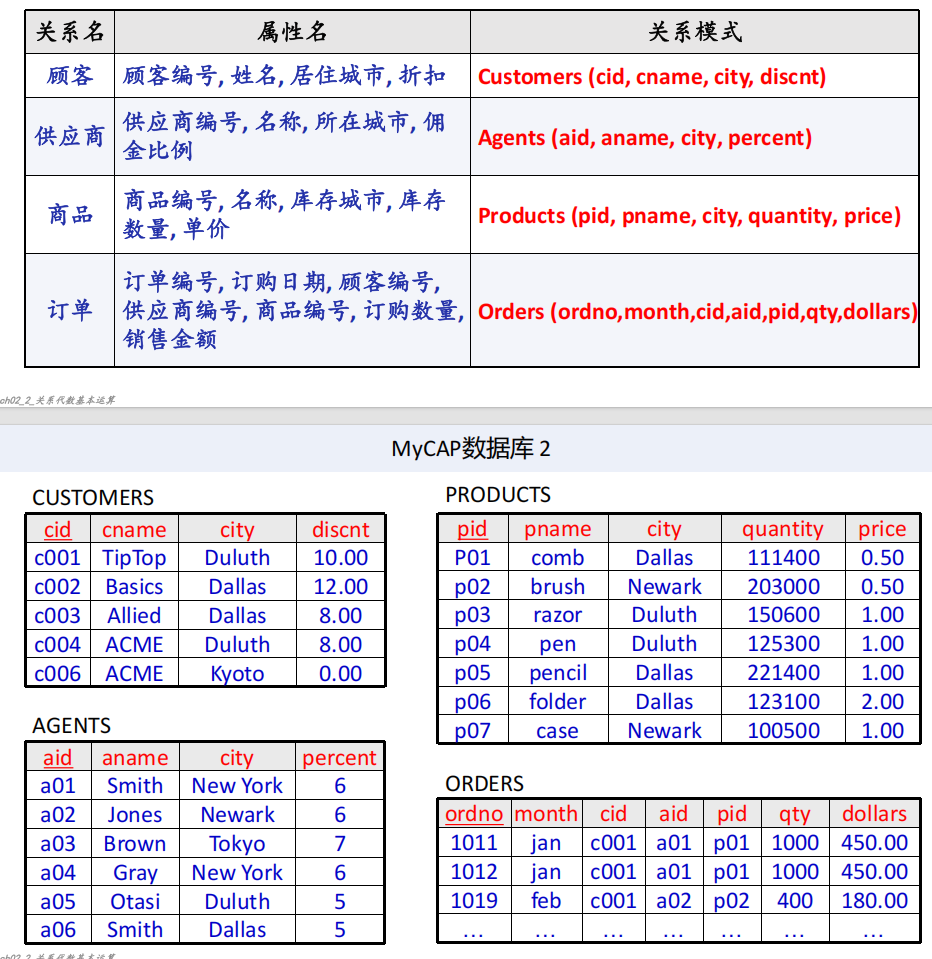
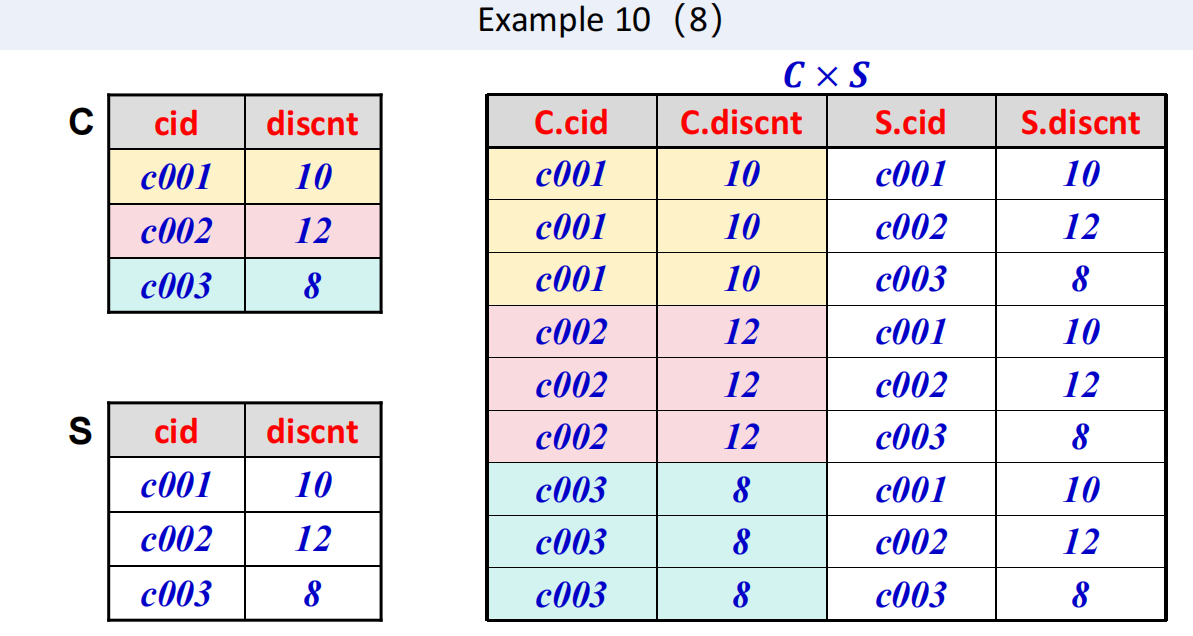
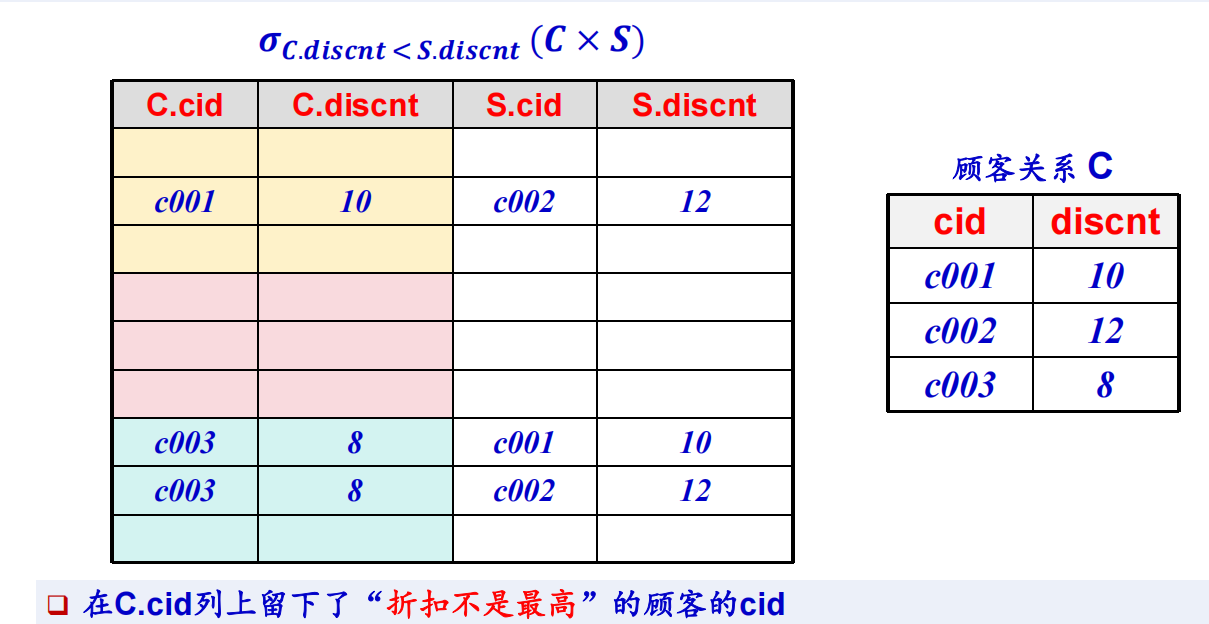
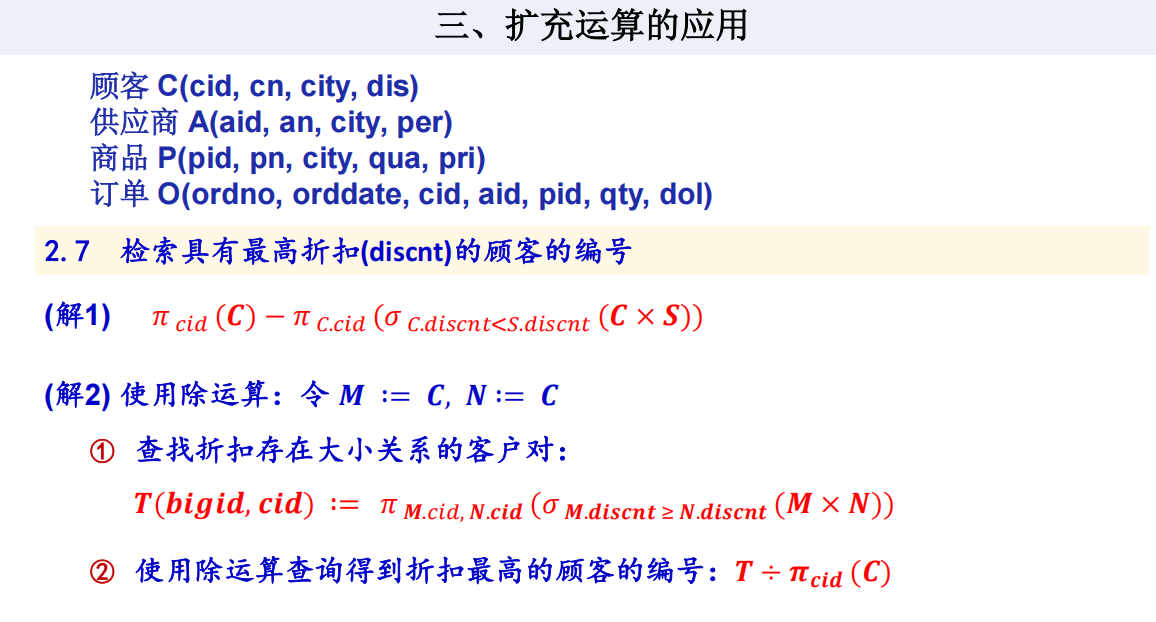
-
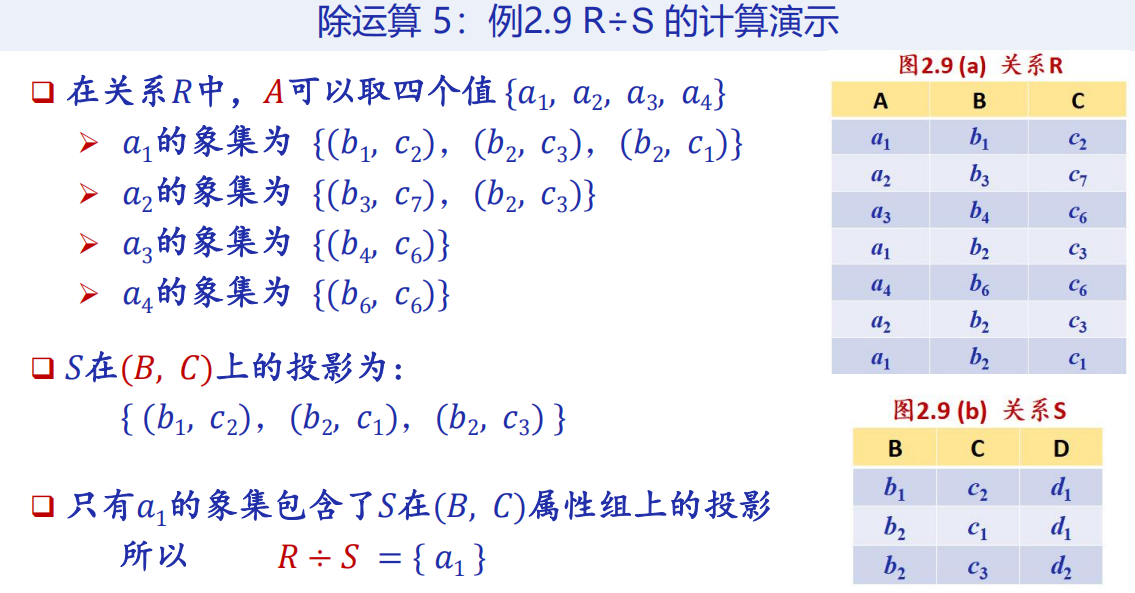
象集
该属性值对应的其他属性值集合,相当于除法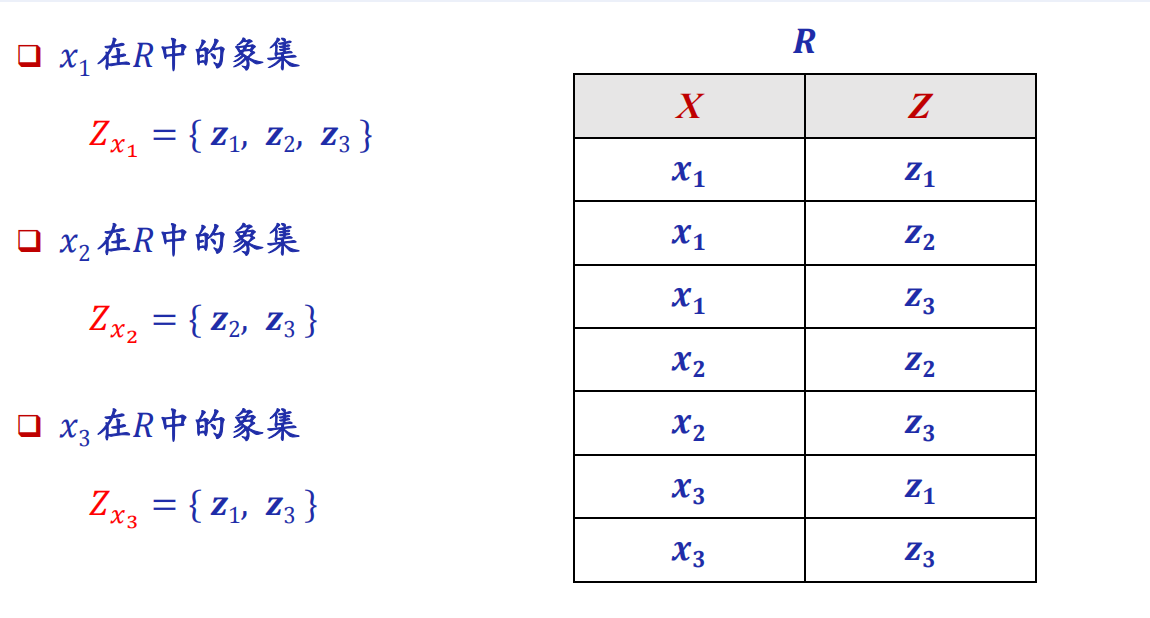
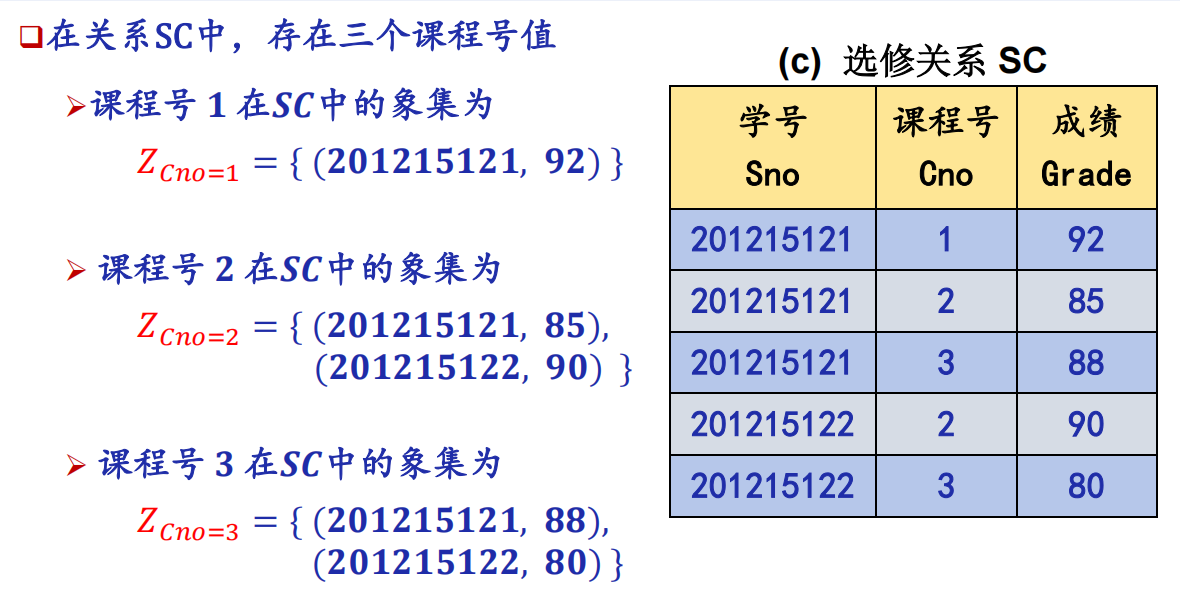
-
除运算 R ÷ S
找出R、S中相同的属性列(B、C),R 剩下的属性列(A) 作为结果。
的所有(,),包含S中的全部b、c。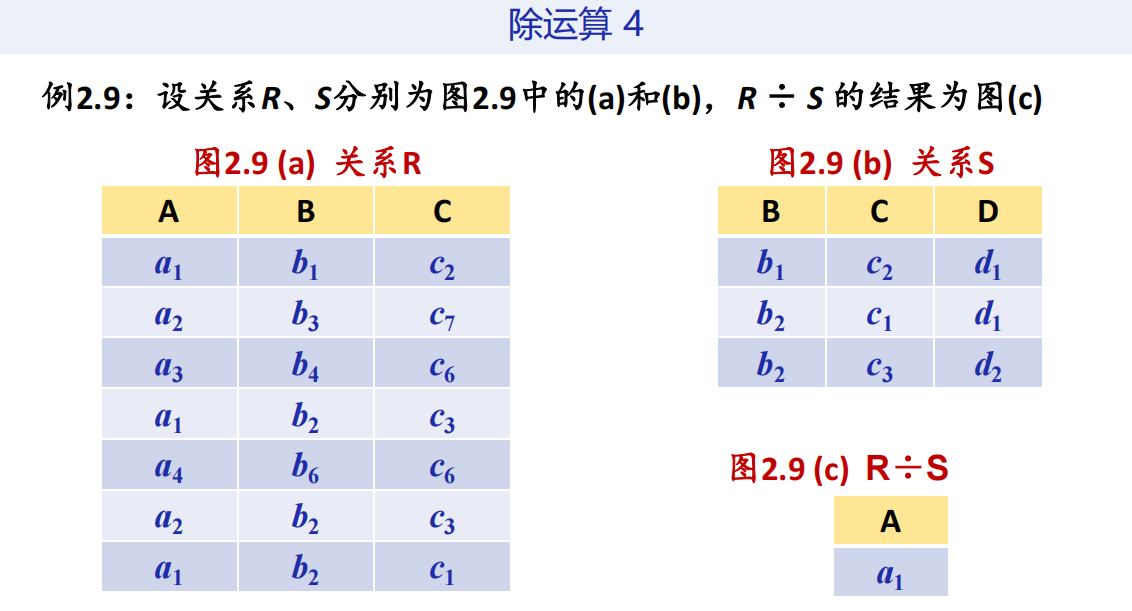
- 例
C3 SQL
- SQL基本执行结构
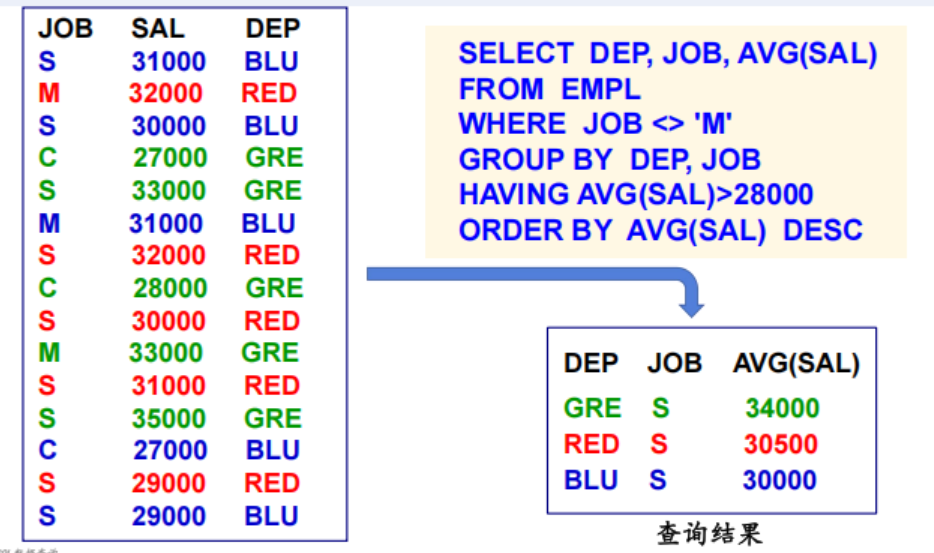
逻辑顺序:SELECT ...FROM ...WHERE ...GROUP BY ...HAVING ...ORDER BY ...;
FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY
基本表 TABLE
-
定义基本表
PRIMARY KEY 主键,唯一标识一行数据,不能重复、不能为空
UNIQUE 唯一,不能重复,但能为空
外键FOREIGN KEY (cno) PREFERENCE course(cno) ON UPDATE/DELETE 规约条件CREATE TABLE Student(Sno CHAR(9) PRIMARY KEY, /* 列级完整性约束条件, Sno是**主码**/Sname CHAR(20) UNIQUE, /* **约束**,Sname的取值具有唯一性*/Ssex CHAR(2) NOT NULL CHECK (Ssex IN ('男', '女')),/* 非空且只能是男/女 */Sage SMALLINT,Sdept CHAR(20));CREATE TABLE enrollment(sno char(9) NOT NULL,clsno char(8) NOT NULL,grade INT CHECK (grade BETWEEN 0 AND 100),PRIMARY KEY(sno,clsno), -- 课程班代码和学号联合构成PRIMARY KEY);CREATE TABLE courseclass(clsno char(8) PRIMARY KEY,cno char(8) NOT NULL,tno char(9) ,-- 先定义再外键 + 违约规则FOREIGN KEY (cno) REFERENCES coures(cno) ON UPDATE CASCADE ON DELETE RESTRICT,FOREIGN KEY (tno) REFERENCES teachers(tno) ON UPDATE CASCADE ON DELETE SET NULL-- 父表更新cno,子表cno自动同步更新;父表删除cno,子表还有该课程就禁止删除-- 父表更新tno,子表tno自动同步更新;父表删除tno,子表对应的tno自动设为NULL);- 违约规则
什么是违约? 父表更新主键/删除父表记录会破坏参照关系,触发违约关键字 中文 含义 CASCADE 级联 父表改 / 删 → 子表自动跟着改 / 删 SET NULL 置空 父表删 → 子表外键自动设为 NULL RESTRICT 限制 / 拒绝 数据库直接禁止父表的改/删操作
- 违约规则
-
修改基本表(ALTER TABLE)
- ADD新增列/完整性约束
ALTER TABLE StudentADD COLUMN S_email VARCHAR(50) NOT NULL UNIQUE; -- 增加邮箱列,要求非空且唯一ADD CONSTRAINT chk_sex CHECK (Ssex IN ('男', '女')); -- 为 Ssex 增加 CHECK 约束(性别只能是男 / 女)
- DROP 删除列
ALTER TABLE StudentDROP COLUMN S_email CASCADE; --删除“邮箱”列,默认RESTRICTDROP CONSTRAINT chk_sex; -- 删除性别CHECK约束
- 修改列的定义
ALTER TABLE StudentALTER COLUMN Sage INT; -- 修改数据类型:年龄从SMALLINT改为INTALTER COLUMN Sname CHAR(30); -- 修改列长度(姓名从 CHAR (20) 改为 CHAR (30))ALTER TABLE Course ADD UNIQUE(Cname); -- 增加课程名称必须取唯一值的约束条件
- ADD新增列/完整性约束
-
删除基本表
DROP TABLE <表名>[RESTRICT| CASCADE];- RESTRICT:只有在该表没有被其他数据库对象依赖时,才能删除。
- CASCADE:删除该表的同时,还会删除依赖于该表的相关对象或依赖关系
视图 VIEW
- 视图的作用?
简化复杂查询;
为不同用户提供不同数据视图;
隐藏敏感属性,提高安全性;
阻止不符合条件的数据加入/修改成不符合条件的数据。 - 定义视图 AS
CREATE VIEW S_G(Sno,Gavg) -- 可选:列名ASSELECT Sno,AVG(Grade)FROM SCGROUP BY Sno;
- 查询视图
- 更新视图
- 删除视图
DROP VIEW S_G [RESTRICT | CASCADE]
- 字符串匹配
- ⭐字符匹配 LIKE/=
SELECT* FROM Student WHERE Sno LIKE '24%' -- 通配符,查询学号以24开头的学生的详细信息SELECT* FROM Student WHERE Sno = '24%' -- 查询学号就是'24%'学生的详细信息- ⭐字符串中的通配符
SELECT Sname, Sno, SsexFROM StudentWHERE Sname LIKE '刘%'; -- 查询所有姓刘学生的姓名、学号和性别SELECT SnameFROM StudentWHERE Sname LIKE '欧阳_'; -- 查询姓"欧阳"且全名为三个汉字的学生的姓名SELECT Sname, SnoFROM StudentWHERE Sname LIKE '_阳%'; -- 查询名字中第2个字为"阳"字的学生的姓名和学号SELECT Sname, Sno, SsexFROM StudentWHERE Sname NOT LIKE '刘%'; -- 查询所有不姓刘的学生姓名、学号和性别 - 多表连接 JOIN
使用 DISTINCT 是为了消除同一学生由于多条匹配记录产生的重复SELECT DISTINCT s.sid, s.snameFROM Student sJOIN Enroll e ON s.sid = e.sidJOIN Course c ON e.cid = c.cidWHERE c.cname = '数据管理基础'AND c.dept = '智软学院';
- DISTINCT 的位置:SELECT 子句;聚集函数内部。
SELECT DISTINCT deptFROM Student;COUNT(DISTINCT sid)AVG(DISTINCT score)SUM(DISTINCT amount)
- DISTINCT 的位置:SELECT 子句;聚集函数内部。
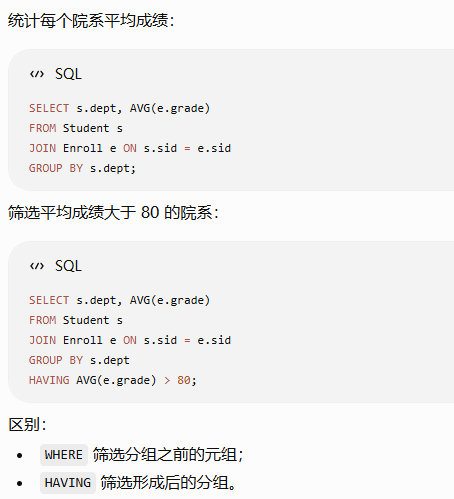
- 分组与 HAVING先Group 分组后 HAVING
- EXISTS
子查询有结果,返回TRUE;子查询无结果,返回FALSE
SELECT SnameFROM Student SWHERE EXISTS (SELECT *FROM SCWHERE SC.Sno = S.SnoAND Cno = '1' -- 从 Student 表里,找出那些‘存在’选修 1 号课程记录的学生); -- 查询选修了 1 号课程的学生SELECT SnameFROM Student SWHERE NOT EXISTS (SELECT *FROM SCWHERE SC.Sno = S.SnoAND Cno = '1'); -- 查询没选1号课程的学生
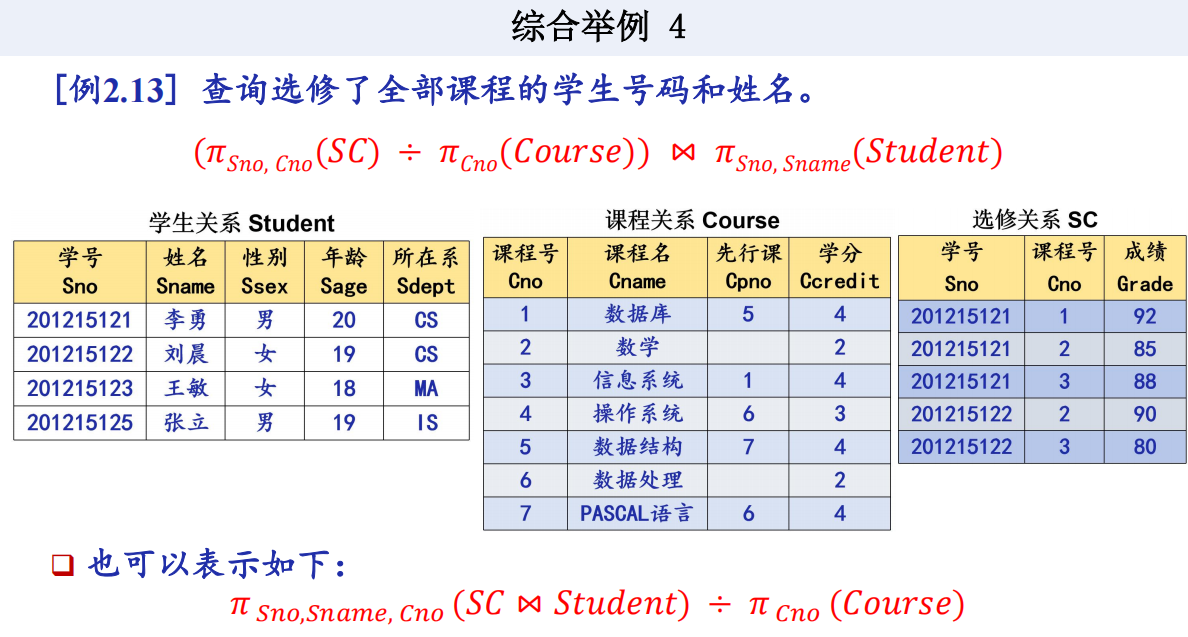
- 查询选修全部课程的学生
SELECT SnameFROM StudentWHERE NOT EXISTS ( -- ③ 除去没有选择课程的学生SELECT *FROM Course -- ② 有NOT EXISTS学生选择的课程中的:学生没有选择的课程WHERE NOT EXISTS (SELECT *FROM SCWHERE SC.Sno = Student.SnoAND SC.Cno = Course.Cno -- ① 对SC中的每门课程,去Student、Course中寻找有无记录) -- 学生选择的课程);✅ 理解:不存在一门课是这个学生没选的
- 例
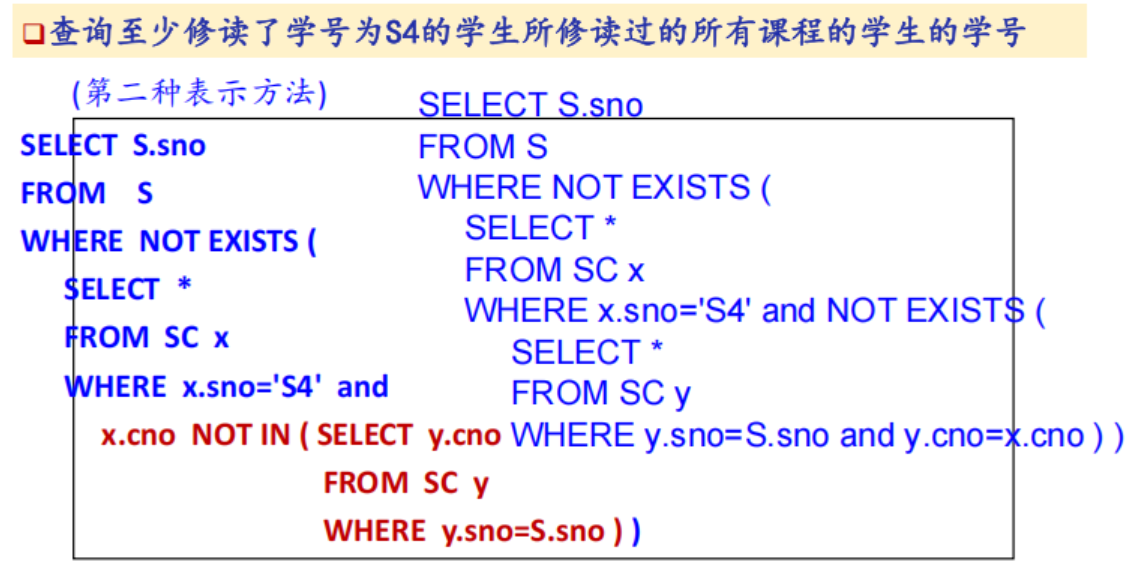
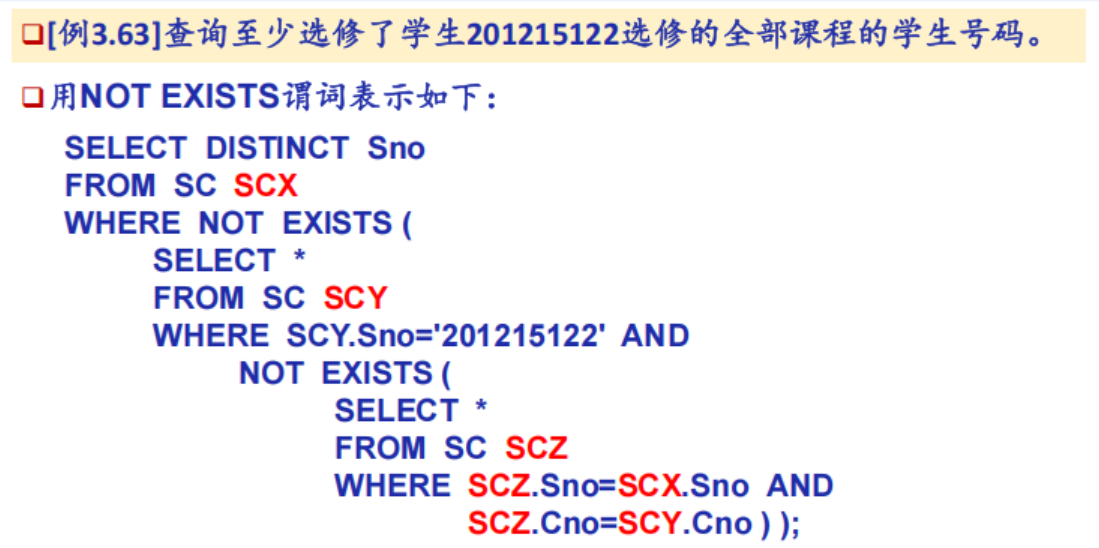
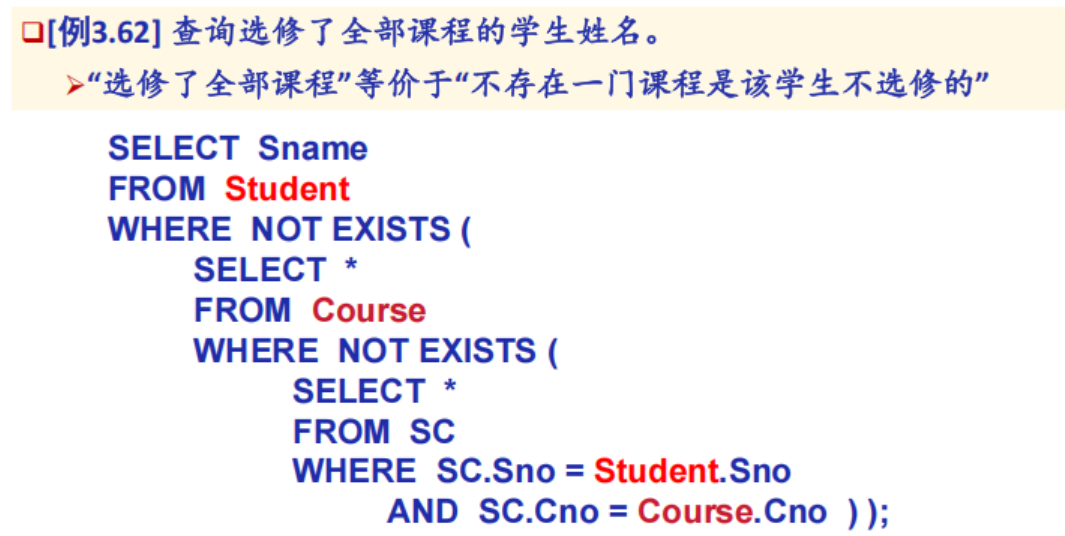
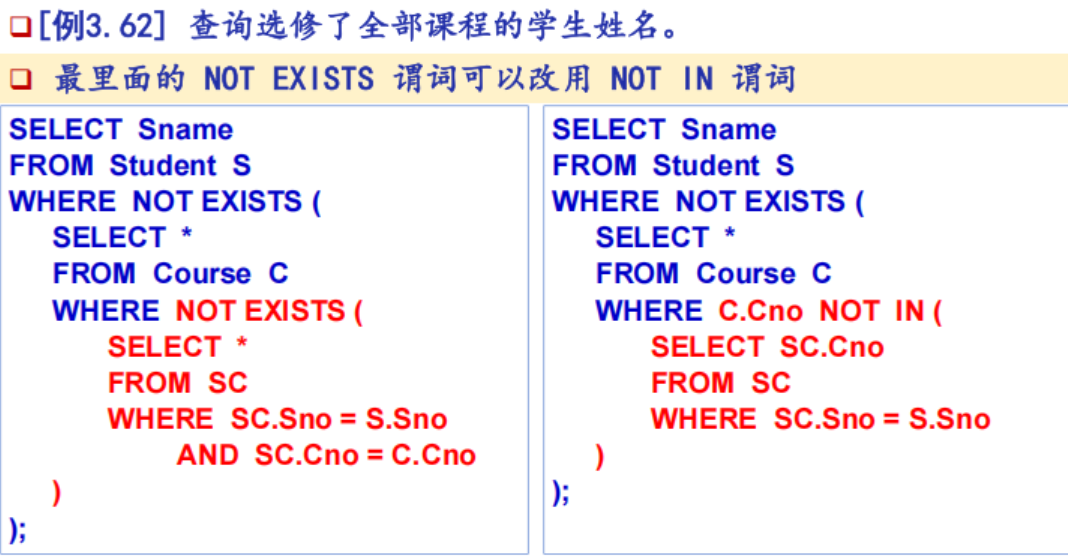
- 查询选修全部课程的学生
⭐例题
-
所有课程都及格:HAVING MIN(grade)>=60
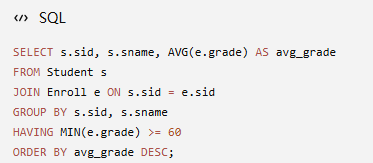
-
修完本院所有必修课
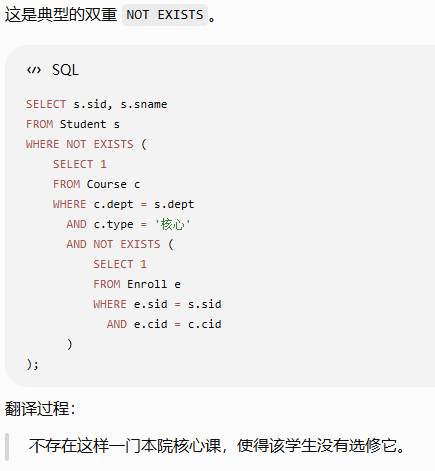
-
每组最大值
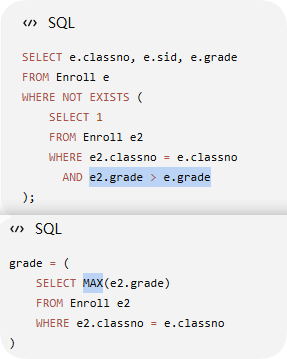
-
只讲授本院课程
-
SQL(Structured Query Language)结构化查询语言,是关系数据库的标准语言
-
SQL与关系数据库的三级模式

-
核心功能:
- 数据定义:CREATE,DROP,ALTER - 数据查询:SELECT - 数据操作:INSERT,UPDATE,DELETE - 数据控制:GRANT,REVOKE
⭐数据库安全性
- 授权:授予GRANT 与 回收REVOKE
- 授予 GRANT
转授 WITH GRANT OPTIONGRANT SELECT,INSERTON StudentTO U1 -- 把对Student的查询、插入权限授予用户U1GRANT ALL PRIVILIGESON TABLE Student,CourseTO U2,U3 -- 把对Student表和Course表的全部权限授予用户U2和U3GRANT SELECTON StudentTO user2WITH GRANT OPTION;
- 回收 REVOKE
REVOKE UPDATE(Sno) ON STUDENT FROM U4 -- 把用户U4修改学生学号的权限收回REVOKE SELECT ON SC FROM PUBLIC -- 收回所有用户对表SC的查询权限
- 授予 GRANT
SQL数据定义
| 操作对象 | 创建 | 删除 | 修改 |
|---|---|---|---|
| 模式 SCHEMA | CREATE SCHEMA | DROP SCHEMA | - |
| 表 TABLE | CREATE TABLE | DROP TABLE | ALTER TABLE |
| 视图 VIEW | CREATE VIEW | DROP VIEW | - |
| 索引 INDEX | CREATE INDEX | DROP INDEX | ALTER INDEX |
定义/删除模式(CREATE/DROP SCHEMA)
-
例:为用户WANG 定义一个学生-课程模式S-T
CREATE SCHEMA “S_T” AUTHORIZATION WANG;CREATE SCHEMA AUTHORIZATION WANG; -- 该语句没有指定<模式名>,<模式名>隐含为<用户名> WANG -
模式中定义其他
为用户ZHANG创建了一个模式TEST,并且在其中定义一个表TAB1
CREATE SCHEMA TEST AUTHORIZATION ZHANG CREATE TABLE TAB1 ( COL1 SMALLINT, COL2 INT, COL3 CHAR(20), COL4 NUMERIC(10,3), COL5 DECIMAL(5,2) );- 删除模式
DROP SCHEMA <模式名> <CASCADE|RESTRICT>
- CASCADE(级联):删除模式的同时,把里面所有表/数据/对象全部删除;
- RESTRICT(限制):模式里有任何东西(表/视图/数据),就禁止删除
egSCHEMA ZHANG CASCADE; 删除模式ZHANG,同时该模式中定义的表TAB1也被删除
索引 INDEX
- 建立索引 CREATE INDEX
CREATE UNIQUE INDEX Coucno ON Course(Cno); -- Course表按课程号CREATE UNIQUE INDEX SCno ON SC(Sno ASC,Cno DESC); -- 升序建唯一索引,SC表按学号升序和课程号降序建唯一索引- 修改索引 ALTER INDEX
ALTER INDEX SCno RENAME TO SCSno; -- 将SC表的SCno索引名改为SCSno- 删除索引 DROP INDEX
DROP INDEX Stusname; -- 删除Student表的Stusname索引关系代数 vs SQL语言
- 其中 for
SQL表示SELECT A_1, A_2, ..., A_mFROM RWHERE F - 笛卡尔积
SQL表示SELECT R.A_1,...,R.A_n,s.b_1,...,s.b_mFROM R,S - 连接
SQL表示SELECT R.A_1,...,R.A_n,s.b_1,...,s.b_mFROM R,SWHERE F - 自然连接
SQL表示SELECT R.A_1,...,R.A_n,s.b_1,...,s.b_mFROM R,SWHERE R.B_1 = S.B_1 and R.B_2 = S.B_2 and ... and R.B_k = S.B_k -
SQL表示SELECT attr_1, attr_2, ..., attr_xFROM R,SWHERE F
SQL数据查询
单表查询
- 基本格式:
SELECT SNO FROM Student WHERE Sage<18 - SELECT 目标子句
- 查所有列:SELECT * FROM Student
- 查指定列:SELECT Sno, Sname FROM Student; 查询全体学生的学号与姓名
- 起别名:SELECT Sname,2026-Sage AS 计算(2026-Sage)结果出生年份起名为AS
- 列去重:SELECT DISTINCT Sno FROM SC; 查询学号

- 计算
SELECT ordno, year(orddate), month(orddate), day(orddate)FROM orders; -- 查询每一份订单的编号、订购的年、月、日;SELECT ordno, orddate, datediff(curdate(), orddate)FROM orders ; -- 查询每一份订单的编号、订购日期、距离至今相隔的天数;
- 例:查询全体学生的姓名、出生年份和所在的院系,要求用小写字母表示系名。
SELECT Sname,'Year of Birth: ', 2014 - Sage, LOWER(Sdept)FROM Student;
- FROM 范围子句
SELECT S.Sno, S.SnameFROM Student S; //S是Student的别名
- WHERE 条件子句
- 比较
SELECT SnameFROM StudentWHERE Sdept = ‘CS’ ;WHERE Sdept <> ‘CS’;//过滤条件,相当于!=不等于- 确定范围
SELECT Sname, Sdept, SageFROM StudentWHERE Sage (NOT) BETWEEN 20 AND 23; -- 查询年龄(不)在[20,23]的学生的姓名、系别和年龄- 确定集合
SELECT Sname, SsexFROM StudentWHERE Sdept (NOT) IN ( 'CS','MA','IS' );-- 查询(不是)计算机科学系(CS)、数学系(MA)和信息系(IS)学生的姓名和性别。- ‘字符串常量’加单引号
SELECT Sname,'Year of Birth: ', 2014 - Sage, LOWER(Sdept) FROM Student;//系名小写- 字符匹配 LIKE/=
SELECT* FROM Student WHERE Sno LIKE '24%' -- 通配符,查询学号以24开头的学生的详细信息SELECT* FROM Student WHERE Sno = '24%' -- 查询学号就是'24%'学生的详细信息- 字符串中的通配符
SELECT Sname, Sno, SsexFROM StudentWHERE Sname LIKE '刘%'; -- 查询所有姓刘学生的姓名、学号和性别SELECT SnameFROM StudentWHERE Sname LIKE '欧阳_'; -- 查询姓"欧阳"且全名为三个汉字的学生的姓名SELECT Sname, SnoFROM StudentWHERE Sname LIKE '_阳%'; -- 查询名字中第2个字为"阳"字的学生的姓名和学号SELECT Sname, Sno, SsexFROM StudentWHERE Sname NOT LIKE '刘%'; -- 查询所有不姓刘的学生姓名、学号和性别- 转义字符 用 ESCAPE ” 表示字符\为换码字符(转义指示符)
查询DB_Design课程的课程号和学分。SELECT Cno,CcreditFROM CourseWHERE Cname LIKE 'DB\_Design' ESCAPE '\' ;WHERE Cname = 'DB_Design'; -- 等效- 涉及空值的查询
SELECT Sno,CnoFROM SCWHERE Grade IS NOT NULL; -- 查所有有成绩的学生学号和课程号- 多重条件查询(AND/OR)
连接查询(多表)
- 等值连接/自然连接查询=
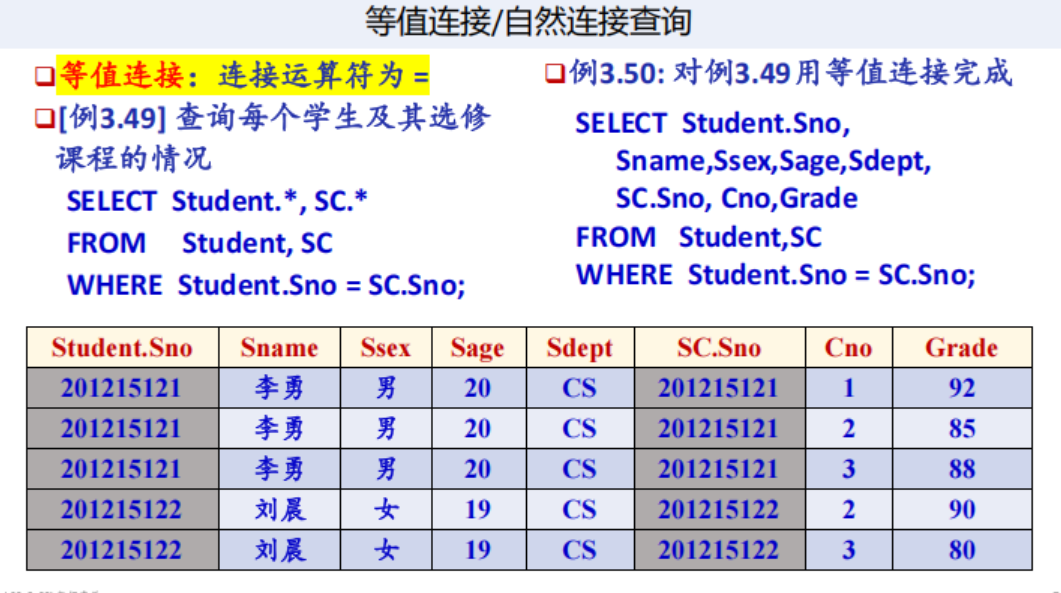
- 自身连接 起别名 =
查询每一门课的间接先修课(即先修课的先修课)SELECT FIRST.Cno, SECOND.CpnoFROM Course FIRST, Course SECOND -- 需要给表起别名WHERE FIRST.Cpno = SECOND.Cno;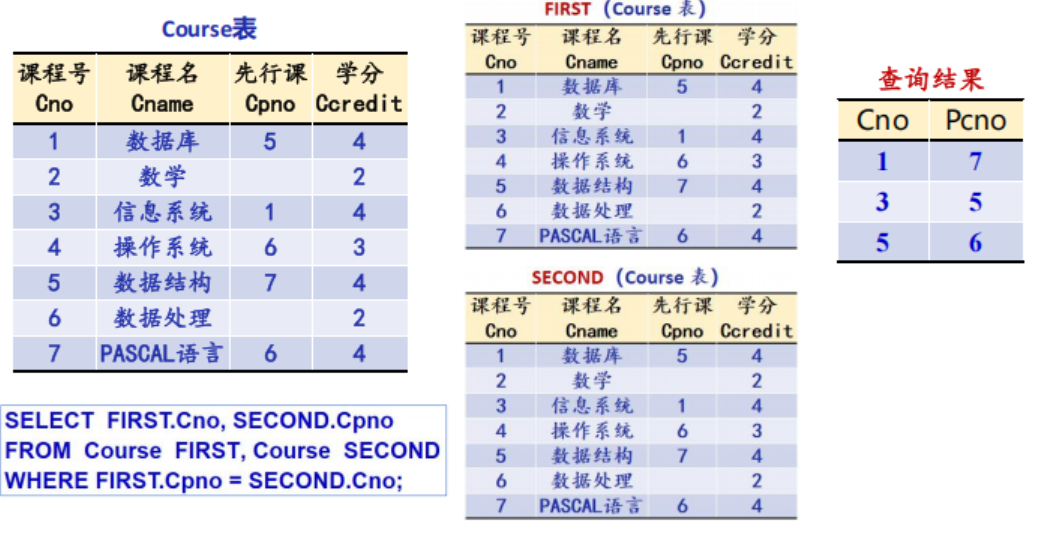
- 外连接
SELECT Student.Sno,Sname,Ssex,Sage,Sdept,Cno,GradeFROM Student LEFT OUTER JOIN SC ON (Student.Sno=SC.Sno); -- 左外连接:左边为标准,右边不存在的填NULLFROM Student RIGHT OUTER JOIN SC ON (Student.Sno=SC.Sno); -- 右外连接:右边为标准,右边不存在的填NULLFROM Student FULL OUTER JOIN SC ON S.Sno = SC.Sno; -- 全外连接,全部补NULL
嵌套查询(子查询)
- IN
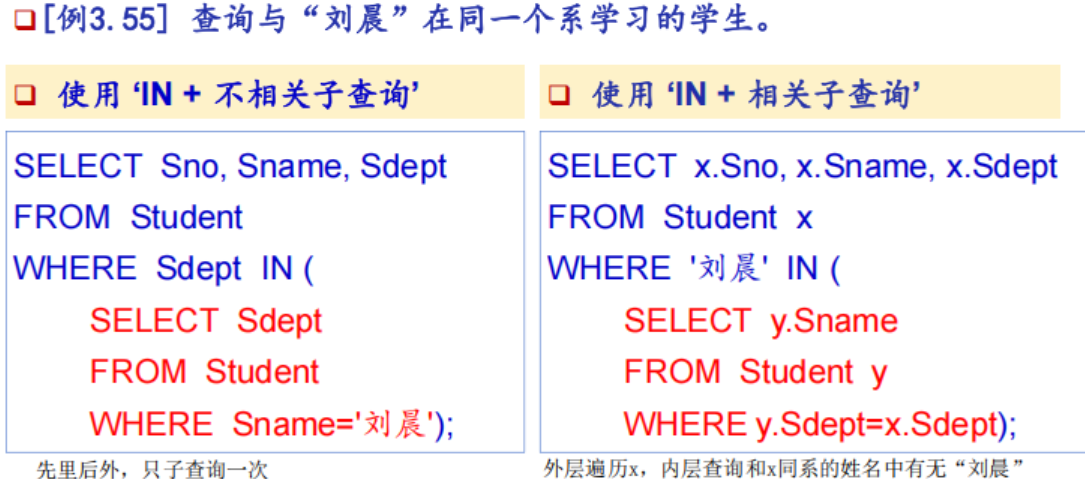
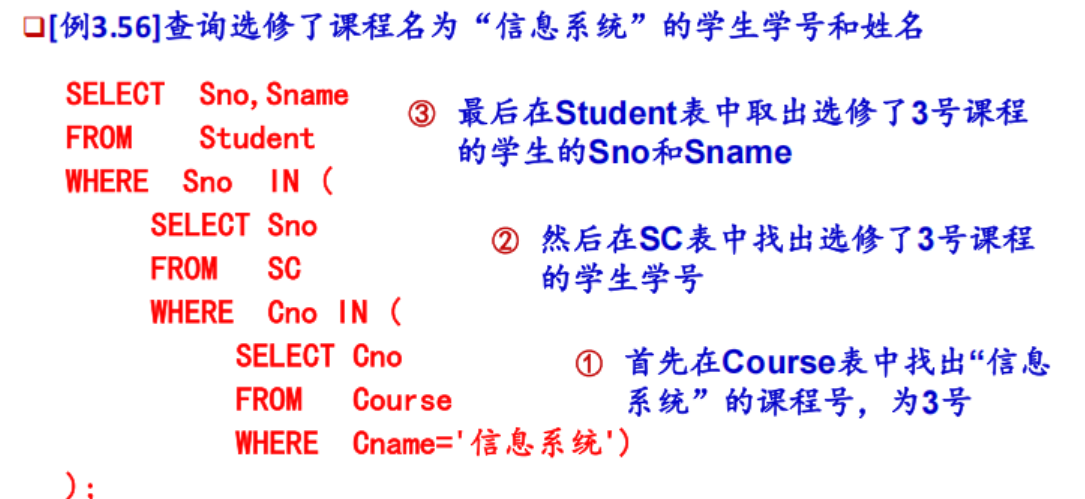
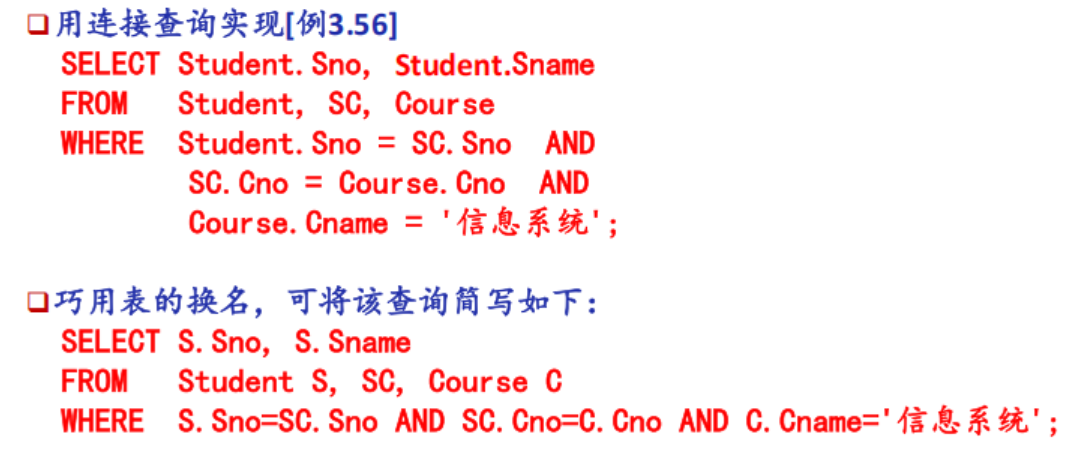
- 带有比较运算符的子查询
SELECT Sno,Sname,SdeptFROM StudentWHERE Sdept = (SELECT Sdept FROM Student WHERE Sname = '刘晨');-- 在[例3.55]中,由于一个学生只可能在一个系学习,则可以用 = 代替INSELECT Sno, CnoFROM SC xWHERE Grade >= ( SELECT AVG(Grade)FROM SC yWHERE y.Sno = x.Sno ); -- 找出每个学生超过他选修课程平均成绩的课程号。
- 限定比较谓词(SOME/ANY/ALL)
< ANY → 小于最大值;-- 查询非计算机科学系中比计算机科学系任意一个学生年龄小的学生姓名和年龄SELECT Sname,SageFROM StudentWHERE Sage < ANY (SELECT SageFROM StudentWHERE Sdept = 'CS')AND Sdept <> 'CS' ;-- 聚集函数SELECT Sname,SageFROM StudentWHERE Sage < (SELECT MAX(Sage)FROM StudentWHERE Sdept= 'CS ' )AND Sdept <> 'CS';SELECT * FROM SCWHERE Grade < ANY (80,90,70); -- 任意一个,小于最大值。成绩 < 90SELECT * FROM SCWHERE Grade < ALL (80,90,70); -- 所有,小于最小值。成绩 < 70
- EXISTS谓词
子查询有结果,返回TRUE;子查询无结果,返回FALSE
SELECT SnameFROM Student SWHERE EXISTS (SELECT *FROM SCWHERE SC.Sno = S.SnoAND Cno = '1' -- 从 Student 表里,找出那些‘存在’选修 1 号课程记录的学生); -- 查询选修了 1 号课程的学生SELECT SnameFROM Student SWHERE NOT EXISTS (SELECT *FROM SCWHERE SC.Sno = S.SnoAND Cno = '1'); -- 查询没选1号课程的学生
- 查询选修全部课程的学生
SELECT SnameFROM StudentWHERE NOT EXISTS ( -- ③ 除去没有选择课程的学生SELECT *FROM Course -- ② 有NOT EXISTS学生选择的课程中的:学生没有选择的课程WHERE NOT EXISTS (SELECT *FROM SCWHERE SC.Sno = Student.SnoAND SC.Cno = Course.Cno -- ① 对SC中的每门课程,去Student、Course中寻找有无记录) -- 学生选择的课程);✅ 理解:不存在一门课是这个学生没选的
- 例
- 查询选修全部课程的学生
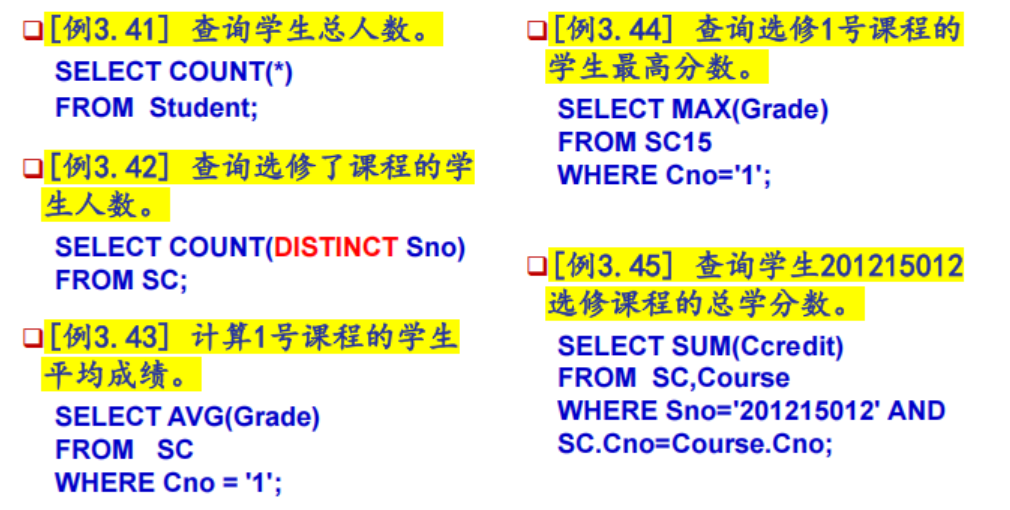
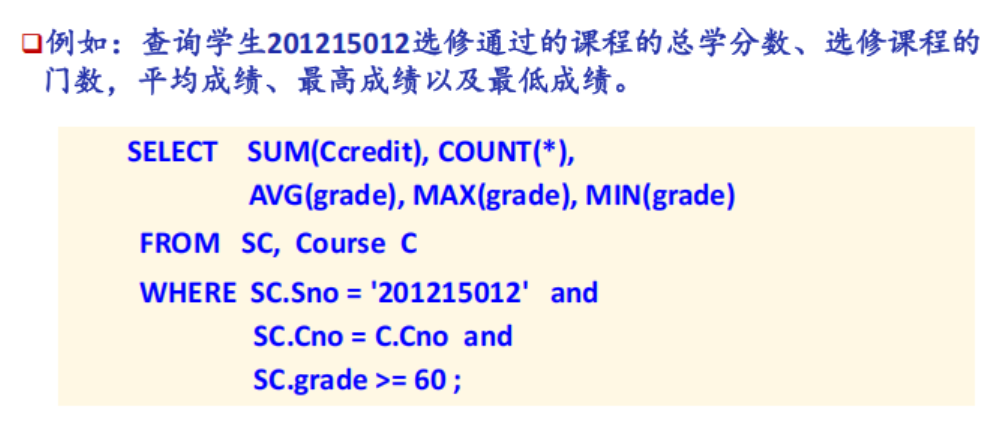
聚集函数/统计函数
- COUNT 统计元组个数
- SUM 计算一列的总和/AVG 计算一列的平均值
- MIN 一列值中的最大值/MIN 一列值中的最小值
对查询结果的处理
- 对查询结果排序 ORDER BY 属性名 ASC升序/DESC降序
查询选修了3号课程的学生的学号及其成绩,查询结果按分数降序排列。
SELECT Sno, GradeFROM SCWHERE Cno= '3'ORDER BY Grade DESC;
- 对查询结果分组 GROUP BY/HAVING
求各个课程号及相应的选课人数。
查询选修了3门以上课程的学生学号。SELECT Cno,COUNT(Sno)FROM SCGROUP BY Cno; // 按照Cno为一行,相同Cno为一行SELECT SnoFROM SCGROUP BY SnoHAVING COUNT(*) >3;
- 辨析 HAVING 与 WHERE

- 辨析 HAVING 与 WHERE
- 指定结果列的列标题
SELECT Sname NAME,'Year of Birth:' BIRTH,2014-Sage BIRTHDAY,-- Sname一列的结果列标题为NAME,'Year of Birth:'常量列的列标题为BIRTH…FROM Student;
- 查询结果
WHERE → GROUP → SELECT → ORDER WHERE → GROUP → HAVING → SELECT → ORDER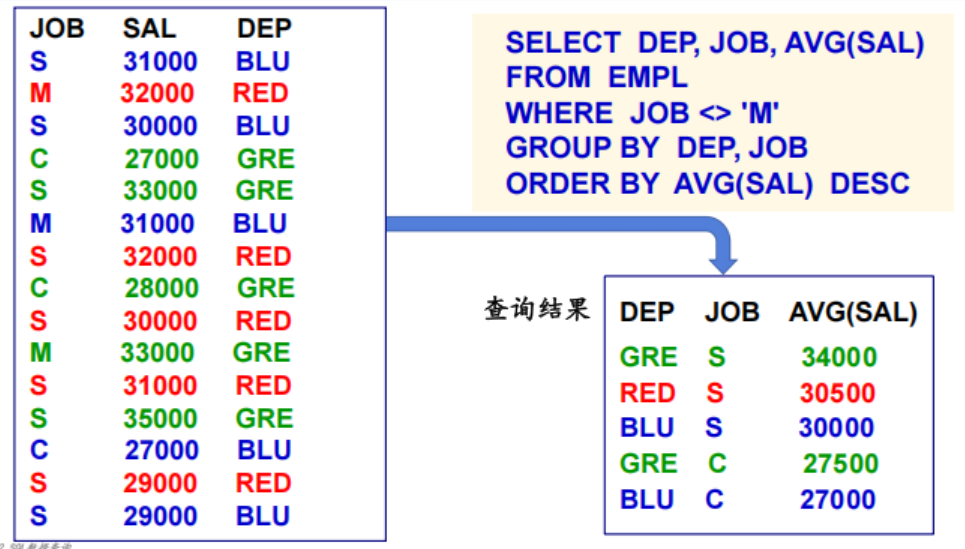
集合操作
- 并操作 UNION [ALL]

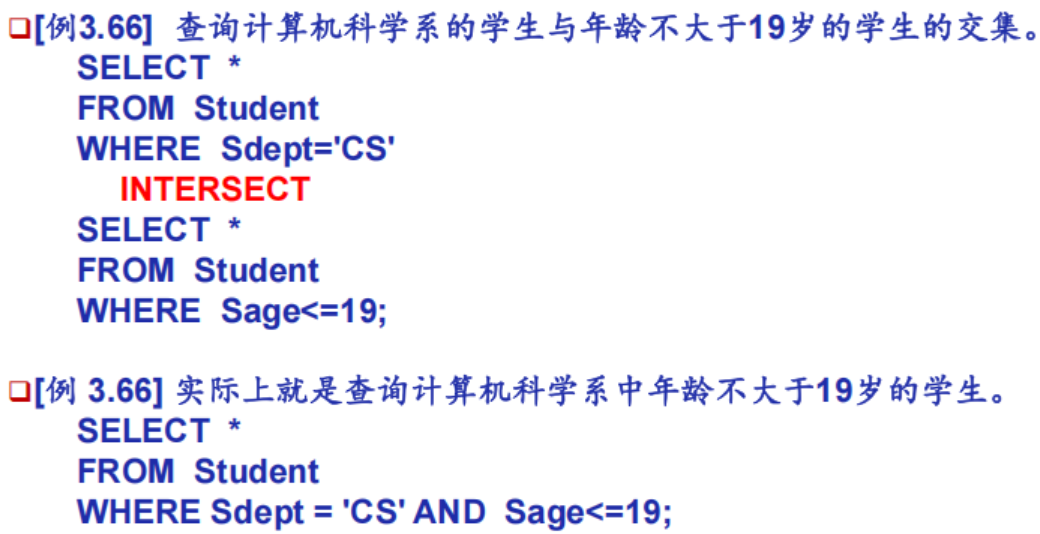
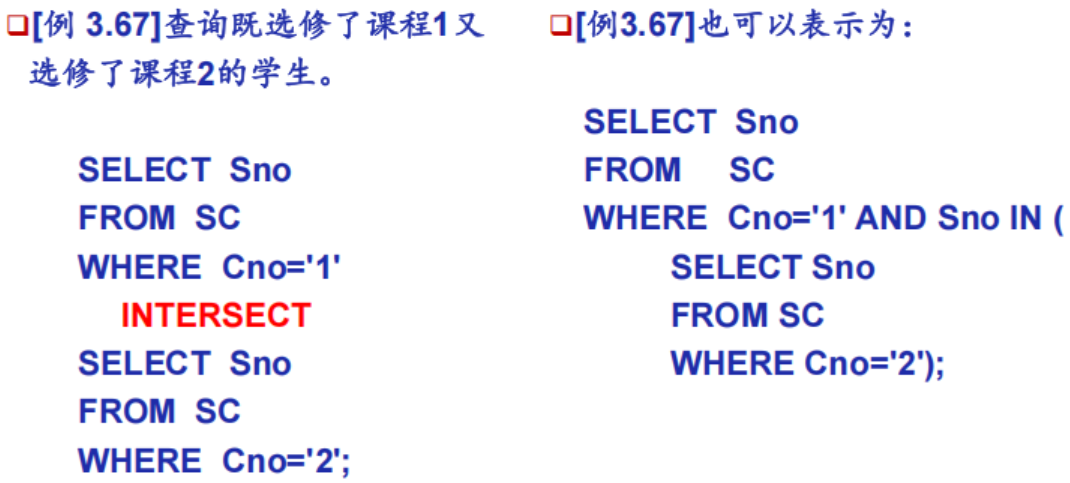
- 交操作 INTERSECT [ALL]
- 差操作 EXCEPT [ALL]
基于派生表的查询
数据更新


事务
- 定义 是用户定义的一个数据库操作序列,这些操作要么全做,要么全不做
- 例

- 事务的特性(ACID) 原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability)
- 定义事务
- 事物的启动:隐式方式(由数据库管理系统来决定,何时为何用户启动一个新的事务)
- 事物的结束:用户调用commit或rollback命令,显式地结束当前事务;由数据库管理系统强行结束一个用户的当前正在运行中的事务
-
事务启动方式
- 数据定义命令 DDL
只要你执行 CREATE、ALTER 等定义语句,系统自动把这一条语句当成一个独立事务。
执行前,如果你正在做其他操作,系统会自动先提交之前的事务。 - 将系统设为自动提交方式(打开自动提交标志)
这是最常见的默认状态。每一条 SELECT、UPDATE 等操作,做完后系统自动帮你 COMMIT,立即生效。 - 数据操纵命令(DML)
如果你没有开启自动提交,当你执行 INSERT/UPDATE/DELETE 时,系统检测到你没有事务,就自动帮你开启一个新事务,等着你手动提交或回滚。
- 数据定义命令 DDL
-
事务结束方式
- 事务提交:COMMIT
事务正常结束,确认所有操作生效 - 事务回滚:ROLLBACK
事务异常终止,撤销所有操作。保存点 savepoint,支持部分回滚。只撤销保存点后的操作
- 事务提交:COMMIT
- 相关的SQL语句
- 事务结束命令 事务提交命令:COMMIT/事务放弃命令:ROLLBACK
- 事务设置命令
- 设置事务的自动提交命令:SET AUTOCOMMIT ON | OFF
- 设置事务的类型:SET TRANSACTION READONLY | READWRITE
- 在MySQL数据库中,设置事务自动提交功能的SQL命令格式是
- SET AUTOCOMMIT = 0; /* 关闭事务自动提交功能 */
- SET AUTOCOMMIT = 1; /* 打开事务自动提交功能 */
- 只读/读写型事务 SET TRANSACTION READONLY | READWRITE ;
- 事隔离级别——解决相互干扰
- READ UNCOMMITTED 读未提交
- READ COMMITTED 读已提交
- REPEATABLE READ 可重复读
- SERIALIZABLE 串行化
- 基于封锁的并发控制(Locking)——具体执行策略
- 读锁(共享锁/S锁) 事务 T 持有读锁时,只允许别人读,不允许写。作用:保证大家看到的是同一时刻的数据。
- 写锁(排他锁/X锁) 事务 T 持有写锁时,别人既不能读,也不能写。作用:保证修改操作不被打断,原子性执行。
- 互斥原则 一个数据对象上,同一时刻只能有一种锁(要么一堆读锁,要么一个写锁),不能混着来。
SQL中的空值
注意取值

视图
- 格式
CREATE VIEW <视图名> [(<列名> [,<列名>]…)]AS <子查询>[WITH CHECK OPTION];
- 例-行列子集视图
若一个视图是从单个基本表导出的,并且只是去掉了基本表的某些行和某些列,但保留了主码,我们称这类视图为行列子集视图。

- WITH CHECK OPTION
 阻止不符合条件的数据加入/修改成不符合条件的数据…/而基本表没有限制
- 建立视图


- 删除视图
DROP VIEW <视图名> [CASCADE]

- 查询视图
- 更新视图
C4 数据库的安全性
数据安全性概述
-
数据库安全性:保护数据库防止非法使用造成的数据泄露、更改或破坏,是数据库系统核心性能指标之一
-
数据库不安全因素 & 安全措施
- 非授权用户对数据库的恶意存取和破坏:用户身份鉴别、存取控制、视图
- 数据库中重要或敏感的数据被泄露:强制存取控制、数据加密存储、加密传输
- 安全环境的脆弱性:建立可信计算机系统
- 故障/误操作/并发访问
-
安全标准
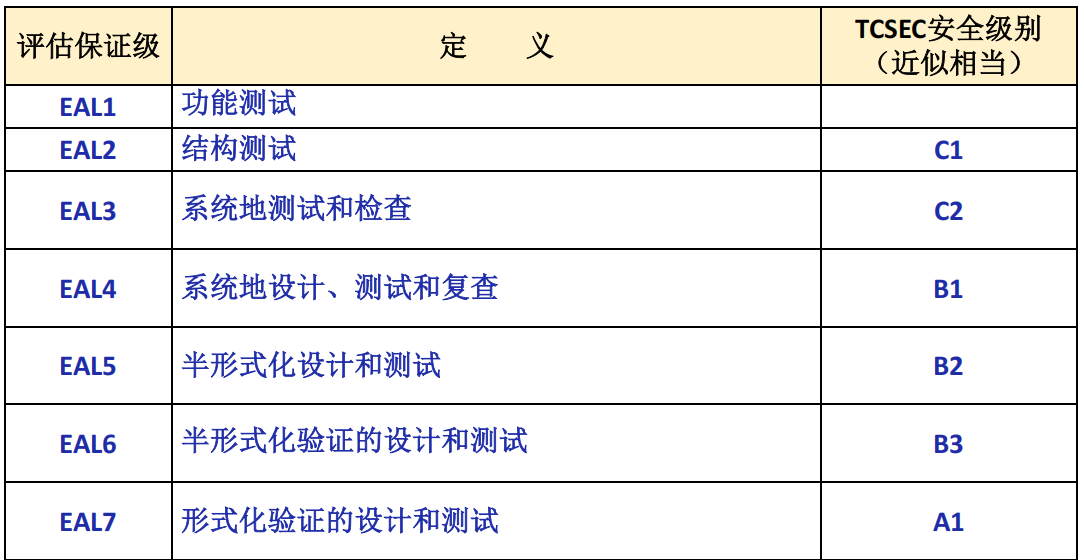
- 美国国防部颁布TCSEC(DoD85) → 不同国家在其基础上建立的评估准则ITSEC/CTCPEC/FC → CC (国际通用标准)
- TCSEC/TDI安全级别划分(从低到高)/ CC评估保证级(EAL)划分
- 中国标准:GB 17859-1999 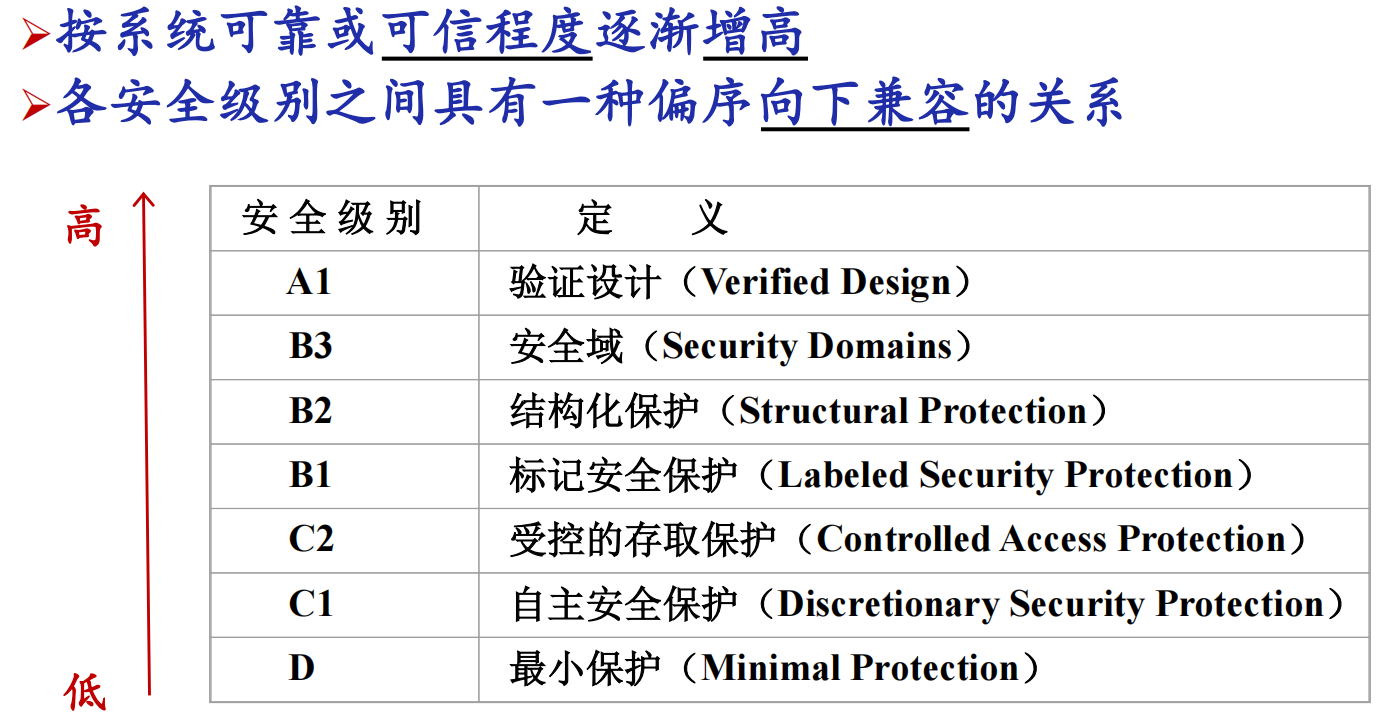
-
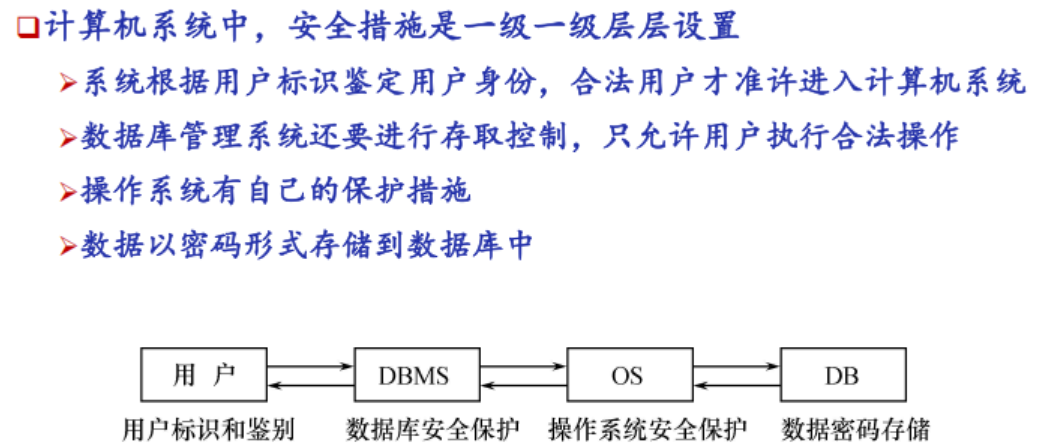
计算机系统的安全模型
-
数据库管理系统安全性控制模型
 数据库安全性控制的常用方法:用户标识和鉴定、存取控制、视图、审计、数据加密
数据库安全性控制
数据库安全性控制的常用方法:用户标识和鉴定、存取控制、视图、审计、数据加密
用户身份鉴别
系统提供的最外层安全保护措施
用户标识 = 用户名 + 用户标识号(用户标识号在系统整个生命周期内唯一)
用户身份鉴别的方法:静态口令鉴别、动态口令鉴别、生物特征鉴别(掌纹/虹膜)、智能卡鉴别
存取控制
- 组成:定义用户权限,并将用户权限登记到数据字典中 + 合法权限检查(用户发出存取数据库的操作请求后,DBMS根据字典检查权限)
- 存取控制方法:自主存取控制、强制存取控制

自主存取控制 DAC
- SQL支持:通过 GRANT语句、REVOKE语句 提供支持
- 核心目标:
- 用户权限的组成要素:数据库对象 + 操作类型

- 用户存取权限的方式
(i) 客体的属主(客体的创建者)自动拥有客体上的所有存取权限
(ii) 拥有权限的用户可以自主地将他拥有的权限传授给在数据库系统中注册的其他用户 5. 访问控制检查流程 第一步:是不是管理员?第二步:是不是客体的属主?第三步:有没有被授予对应的权限?(检查用户 S 是否被授予了“以方式A 访问 客体O”的权限)
数据库角色 ROLE
强制存取控制 MAC
其他安全技术
视图机制、审计(Audit)、数据加密、其他安全性保护
C7 数据库设计
数据库设计的基本方法
| 设计方法 | 对象 | 目的 |
|---|---|---|
| 新奥尔良法 | 整体的数据库设计流程方式 | 覆盖各阶段 |
| 基于E-R模型设计 | 概念结构设计 | 用 E-R / EER 图把用户需求抽象成实体、属性、联系 |
| 3NF设计方法 | 逻辑结构设计 | 将概念模型转为关系表,并保证满足3NF |
| 面向对象的数据库设计方法 | 面向对象数据库 | 把实体看作对象,属性/方法封装在对象中 |
| 统一建模语言(UML)方法 | 概念建模/逻辑设计 | 用类图、对象图、时序图等 UML 工具表示 |
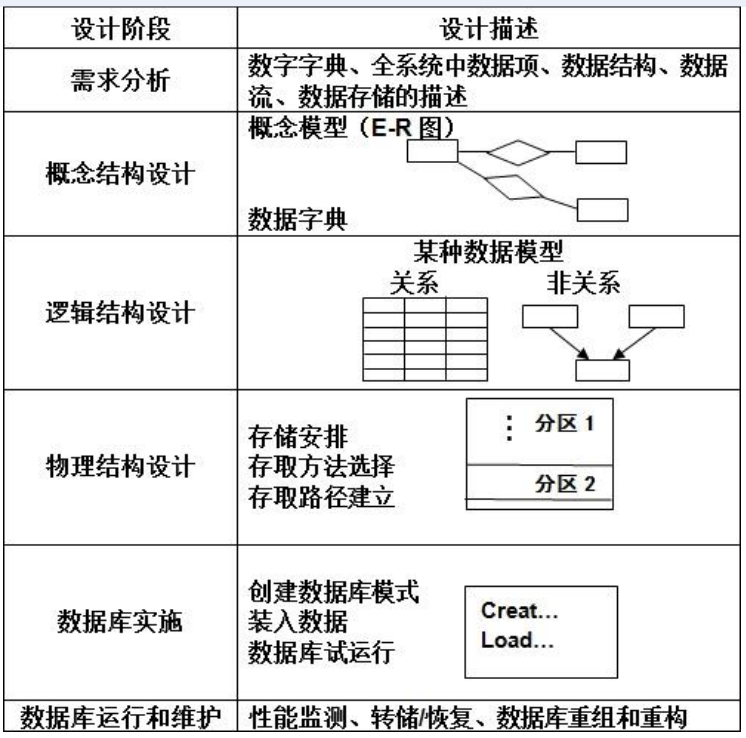
数据库设计基本步骤(新奥尔良法)
| 工作 | 所属阶段 |
|---|---|
| 收集业务需求、数据流 | 需求分析 |
| 画 ER/EER 图 | 概念结构设计 |
| ER 转关系模式、规范化 | 逻辑结构设计 |
| 设计索引、文件组织、聚簇 | 物理结构设计 |
| 建表、装载数据、编程 | 数据库实施 |
1. 需求分析
-
目标:明确用户信息需求(What)与处理需求(How),为概念设计提供基础
-
需求分析产出结果
- 数据字典(学号:字符型,10位,唯一标识学生)
- 用户需求规格说明书(学生可以选课、退课、查成绩;教师可以录入成绩)
- 这两个结果是概念结构设计的基础输入(为下一步画 E-R 图提供依据)
-
数据字典 DD

2. 概念结构设计
-
概念结构设计:把需求抽象成概念模型
-
描述概念模型的工具:E-R 模型 / EER 模型
-
概念结构设计方法
自顶向下、自下向上、二者混合策略、逐步扩张(学生的核心需求和概念结构 → 再扩展教师等其他需求和概念结构)

E-R模型设计原则
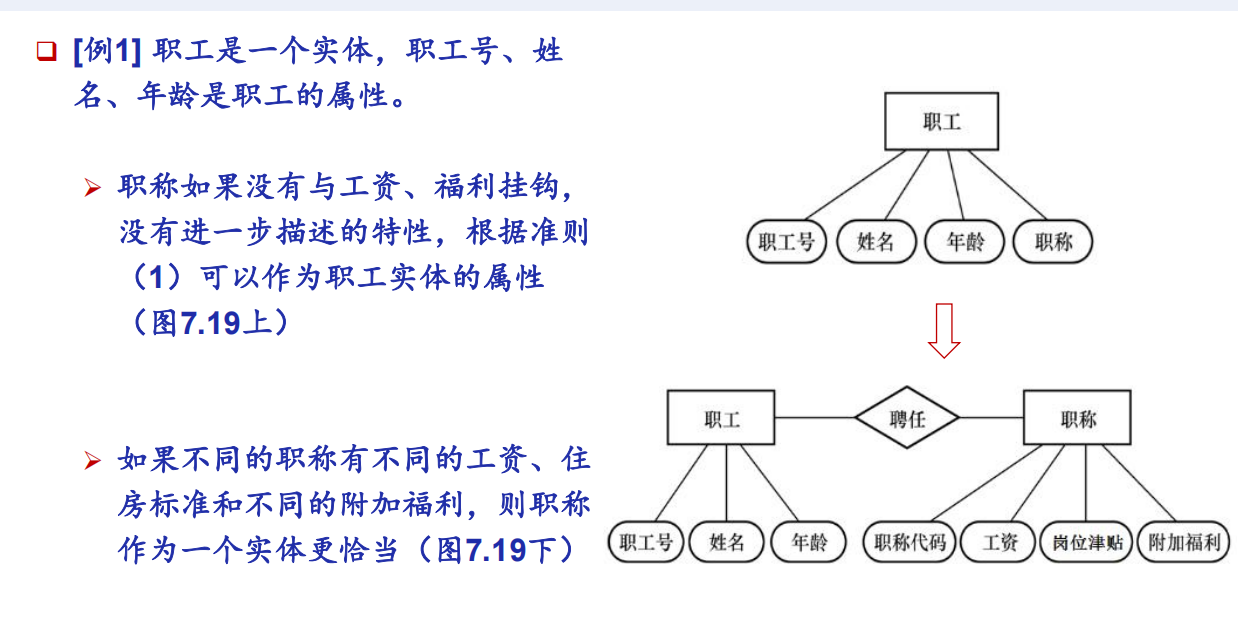
i、实体 or 属性
-
原则:能作为属性处理的,尽量作为属性处理,以简化 E-R 图
-
两条判断准则:
- 如果某个对象本身还需要描述其他性质,应作为实体
- 如果某个对象还要和其他实体发生联系,应作为实体
-
例
ii、实体 or 联系
-
实体:可以独立存在的持久对象
- 例:学生、课程、商品、顾客、订单
-
联系:因为某种事情发生而产生的信息,通常依赖多个实体
- 例:学生选课、顾客购买商品、教师讲授课程
-
有些事件也可以被设计成实体
- 例:订单
- 如果只是简单零售购买行为。
若购买动作有属性(购买时间、购买数量等),这些信息只在购买发生时才存在,不能直接放在顾客/商品上 → 属于联系属性购买[时间、数量]顾客 —— 购买(时间,数量) —— 商品 - 如果大量购买,订单有订单号、时间、金额、状态等属性,应把订单作为实体
顾客 —— 下达 —— 订单;订单 —— 包含 —— 订单明细
- 如果只是简单零售购买行为。
- 例:订单
iii、二元联系 or 多元联系
- 二元联系:两个实体之间的联系
- 例:
学生 —— 选修 —— 课程
- 例:
- 多元联系:三个或更多实体之间的联系
- 例:供应商给某项目供应某零件
联系上可以有属性:供应量、供应日期、价格供应商 —— 供应 —— 项目 —— 零件
- 例:供应商给某项目供应某零件
iv、属性依附于实体 or 联系
-
实体属性:实体本身具有的属性
- 例:
学生姓名 属于 学生;课程学分 属于 课程
- 例:
-
联系属性:跟随联系存在而存在,消亡而消亡的属性
- 例:
学生 —— 选修(成绩, 选课时间) —— 课程
- 例:
E-R图集成
- 处理冲突:命名冲突、属性冲突、结构冲突
- 消除冗余:冗余数据可由基本数据推出,冗余联系可由其他联系推出(适当保留提高效率)
3. 逻辑结构设计
-
逻辑结构设计:把 E-R 图翻译成关系表
-
实体集 & 属性 → 表
- 规则1:实体集转换为关系模式
- E-R图中有实体:科室、医生、病人、病例
→ 科室表、医生表、病人表、病例表 - E-R图中有实体:医生,有属性:医生号,姓名,职称
→ 医生(医生号,姓名,职称)
- E-R图中有实体:科室、医生、病人、病例
- 规则2:组合属性拆成子属性
- 不写emp_address,而是子属性(staddress、city、state、zipcode 要么全为空,要么全不为空)

- 不写emp_address,而是子属性(staddress、city、state、zipcode 要么全为空,要么全不为空)
- 规则3:多值属性拆成新表
- 对于学号S1307,姓名王承志,选修课程(Database, Operating System, Computer Network)
- 方法一:纵向展开;方法二:分解出去,单独成表

- 规则1:实体集转换为关系模式
-
联系转换 & 全参与/非全参与
- 补充:实体集与联系的全参与/非全参与

-
1:1联系转换
-
1:1 联系可以单独建表,也可以合并到任意一端(要考虑是否全参与)
-
规则
参与情况 建表方式 例子 两边非全参与(0..1/0..1) 联系单独建表 电单车—电池 一边全参与(1..1),一边非全参与(0..1) 依赖存在方+依赖的主码 人—驾驶证 两边全参与(1..1/1..1) 联系和实体合并成一个表 学生—校园卡 -
例:非全参与、非全参与(分开单独建表)
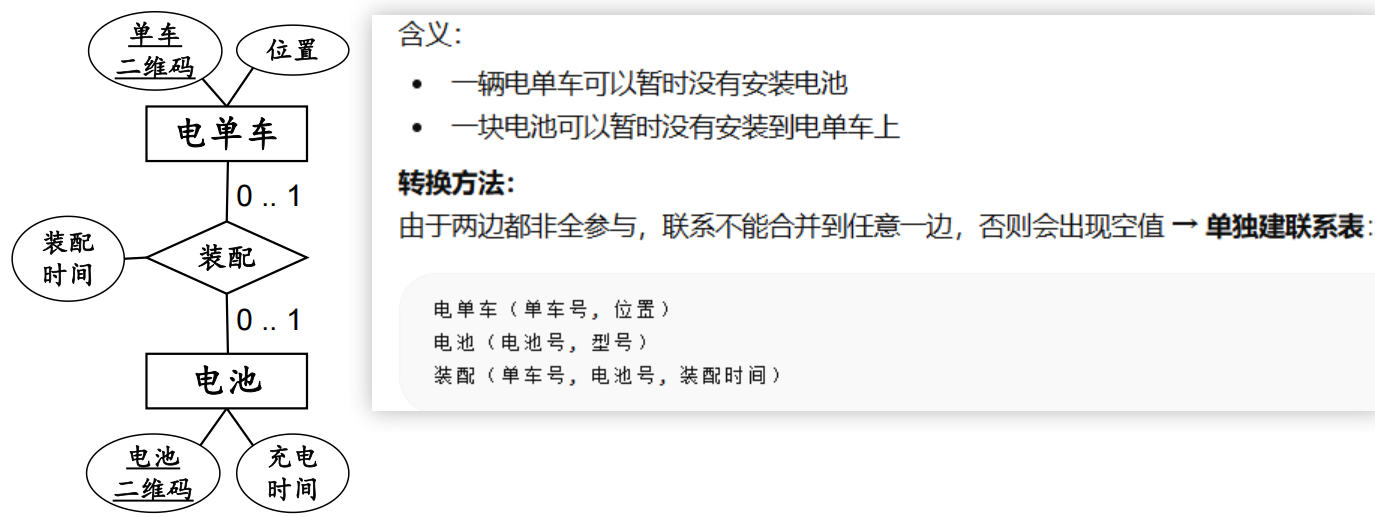
-
例:全参与、非全参与(依赖存在的全参与端驾驶证要加上依赖存在的人的主码)
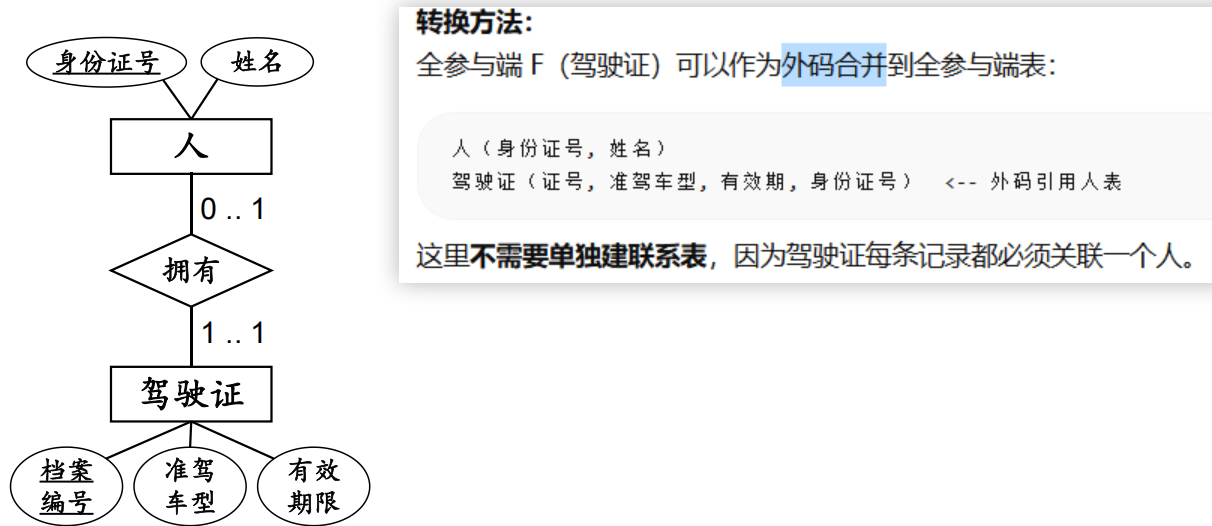
-
例:全参与、全参与(合并)
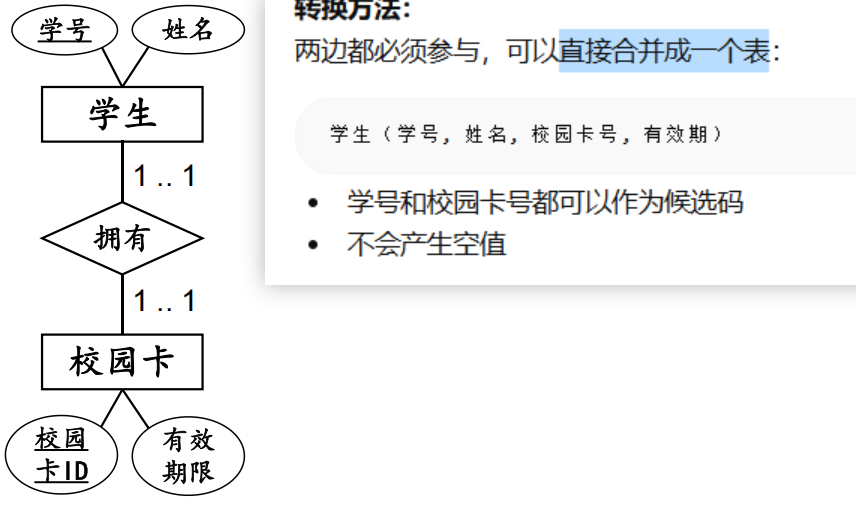
-
-
1
联系转换 - 1
联系通常把 1 端的主码加入到 n 端作为外码 - 多端全参与:多方加上外码

- 多端非全参与:3张表

- 1
-
m
联系转换
- 建3张表
- 例:病人去医生那就诊(一个医生有多个病人,一个病人也有多个医生)
病人(病人号,姓名)医生(医生号,姓名)就诊(病人号,医生号,就诊时间,就诊记录)-
多元联系转换
- 实体建表之外,多元联系也建一个表
- 例:供应商向项目供应零件(E-R图中E-R 图:供应商 —— 供应 —— 项目 —— 零件)
某供应商给某项目供应某零件,供应量是多少。
供应商(供应商号, 供应商名)项目(项目号, 项目名)零件(零件号, 零件名)供应(供应商号, 项目号, 零件号, 供应量) -
单个实体集内部的联系转换
- 例:职工之间存在领导关系
这里“领导职工号”也是职工号,表示该职工的上级(1:1)
职工(职工号, 姓名, 领导职工号)- 如果是 m
的内部关系,需要新建关系
职工(职工号, 姓名)合作(职工号1, 职工号2, 项目名)- 例:一个职工可以管理多个下级职工、一个职工只能有一个上级职工

- 例:职工之间存在领导关系
-
ISA联系转换(父子类)
- 方法一:建3个表(不相交 + 部分特化)
建学生(),教师(),职工(),硕导(),博导()
- 方法二:只建2个子表(不相交 + 完全特化II)
- 方法三:建1个表
- 方法一:建3个表(不相交 + 部分特化)
- 补充:实体集与联系的全参与/非全参与
-
具有相同码的关系模式合并
- 如果两个关系模式具有相同主码,且语义上属于同一对象,可以考虑合并
- 例:
学生基本信息(学号, 姓名, 性别)学生学籍信息(学号, 专业, 入学年份)可以合并为:
学生(学号, 姓名, 性别, 专业, 入学年份)
数据模型优化
- 数据模型优化通常用规范化理论作指导
- 目标:
- 减少数据冗余(拆成多个表)
- 避免更新异常
- 避免插入异常
- 避免删除异常
- 提高数据一致性
- 分解方法:水平分解(分行:分成23级学生、24级学生)、垂直分解(分列:分成学生基本信息+联系方式)
- 设计用户子模式(视图)
- 视图作用:
简化用户操作;
满足不同用户需求;
隐藏敏感数据,保证安全性;
封装复杂查询。
- 视图作用:
物理结构设计
- 物理结构设计:为逻辑数据结构选择最适合应用环境的物理结构
- 常见的存取方法
方法 适合场景 B+ 树索引 范围查询/连接/排序/最值 Hash 索引 等值查询/连接 聚簇存取 经常按某属性集中访问的数据
数据库实施
⭐C8 数据库编程
SQL语言的三种使用方式:交互式SQL(可独立运行)、嵌入式SQL(主语言+ESQL)、过程化SQL
嵌入式SQL
- 嵌入式SQL是将SQL语句嵌入程序设计语言中,被嵌入的程序设计语言称为 (宿)主语言。如Java、C++
-
格式
前缀 EXEC SQL 后缀 ; into获取结果元组值 前缀 : 来区分主变量
EXEC SQL select Sno, Sname, Sageinto :hsno, :hsname, :hsage -- 输出主变量(由SQL语句对其赋值/设置状态信息,返回给应用程序)from Studentwhere Sno = :givensno ; -- 输入主变量(由应用程序对其赋值,在SQL语句引用)-- 根据程序传入的学号,从 Student 表查询单个学生的学号、姓名、年龄,并把结果存入主变量 -
SQL通信区(SQLCA)
SQL语句执行后,数据库系统需要反馈给应用程序的信息:描述系统当前工作状态、描述运行环境
这些信息将送到并保存在SQL通信区中、应用程序从SQL通信区中获取这些状态信息。- 定义SQLCA
用EXEC SQL INCLUDE SQLCA定义 - 使用SQLCA
SQLCA中有一个用于存放每次执行SQL语句后返回当前SQL语句执行状态的代码变量SQLCODE;
每执行完一条SQL语句之后都测试:执行成功返回SUCCESS(0),否则表示出错或异常。 SQLCODE的值,以了解该SQL语句执行情况并做相应处理。
- 定义SQLCA
-
主变量
嵌入式SQL语句中可以使用的主语言程序变量
-
指示变量
是一个整型变量,是一种特殊的主变量,用来“指示”相关主变量的值是否为 空值
指示变量的用途:指示输入主变量是否为空值;检测输出变量是否为空值,值是否被截断指示变量取值 含义 0 主变量正常接收到了非空的数据库值 > 0 数据库字符串被截断,只存了部分到主变量 -1 数据库值是NULL,主变量里的值无意义 -
例:查询返回的Grade属性值是否为NULL/根据课程号把该课程的成绩都置为空。
EXEC SQL SELECT Sno, Cno, GradeINTO :Hsno, :Hcno, :Hgrade :Gradeid-- 多一个:Gradeid。:Hgrade 是接收成绩的主变量,:Gradeid 就是它的指示变量FROM SCWHERE Sno = :givensno AND Cno = :givencno;-- 如果数据库里 Grade 不是空值 → Gradeid = 0,可以直接用 Hgrade 的值-- 如果数据库里 Grade 是 NULL → Gradeid = -1,说明 Hgrade 里的值是无效的,不能直接用gra_ind = -1 ; -- 要把数据库里的值改成 NULLEXEC SQL UPDATE SCSET Grade = :Hgrade INDICATOR :gra_ind-- 把 Grade 字段的值设置成 :Hgrade,但要首先参考指示变量 gra_ind-- 数据库会忽略 :Hgrade 里的数字,直接把 Grade 设为 NULLWHERE cno = :givencno; -- 根据学号查找 -
为了使用主语言变量,必须首先在DECLARE SECTION部分声明这些变量
Why? 编译时类型检查、预先申请内存空间。只有在declare section中定义的主语言变量才能被用在ESQL中exec sql begin declare section; -- 主变量声明开始char hsno[10],givensno[10], hsname[21];int hsage;exec sql end declare section; -- 主变量生声明结束EXEC SQL select Sno, Sname, Sageinto :hsno, :hsname, :hsagefrom Studentwhere Sno = :givensno ; --根据学号查询学号、姓名、年龄
-
-
⭐游标 Cursor
游标是系统为用户开设的一个数据缓冲区,用于存放SQL查询的执行结果。解决SQL批量返回数据、主语言单条处理之间的矛盾
- 声明游标
EXEC SQL DECLARE 游标名 CURSOR FOR 查询语句; - 打开游标
EXEC SQL OPEN 游标名; - 提取数据
EXEC SQL FETCH 游标名 INTO 主变量; - 关闭游标
EXEC SQL CLOSE 游标名;
- 声明游标
-
过程
- 建立/关闭数据库连接
EXEC SQL CONNECT TO target [AS 连接名] [USER 用户名]; -- 建立连接EXEC SQL SET CONNECTION 连接名 | DEFAULT; -- 切换连接EXEC SQL DISCONNECT 连接名 | DEFAULT; -- 关闭连接
- 例
依次检查某个系的学生记录,交互式更新某些学生年龄。
EXEC SQL BEGIN DECLARE SECTION; /*主变量声明开始*/char Deptname[21];char Hsno[10];char Hsname[21];char Hssex[3];int HSage;int NEWAGE;EXEC SQL END DECLARE SECTION; /*主变量声明结束*/long SQLCODE;EXEC SQL INCLUDE SQLCA; /*定义SQL通信区*/#include <sqlca.h>int main(void) /*C语言主程序开始*/{int count = 0;char yn; /*变量yn代表yes或no*/printf("Please choose the department name(CS/MA/IS): ");scanf("%s",deptname); /*为主变量deptname赋值*/EXEC SQL CONNECT TO TEST@localhost:54321 USER "SYSTEM"/"MANAGER"; /*连接数据库TEST*/-- 我现在要登录连接到数据库,数据库地址是本机,端口是 54321,数据库名字叫 TEST,登录账号是 SYSTEM,密码是 MANAGEREXEC SQL DECLARE SX CURSOR FOR /*定义游标SX*/SELECT Sno,Sname,Ssex,Sage /*游标SX对应的查询语句*/FROM StudentWHERE SDept = :deptname;EXEC SQL OPEN SX;/*打开游标SX,执行游标对应的查询,并指向查询结果的第一行*/for (;;) -- 循环读取游标里的每一条数据,直到游标读完 / 出错时退出{/* 推进游标,将当前数据放入主变量 */EXEC SQL FETCH SX INTO :Hsno, :Hsname, :Hssex, :HSage;if (sqlca.sqlcode != 0) { -- 操作不成功时退出break;}/* 是第一行的话,打印表头和学生信息 */if (count++ == 0) {printf("\n%-10s %-20s %-10s %-10s\n", "Sno", "Sname", "Ssex", "Sage");}/* 打印当前学生信息 */printf("%-10s %-20s %-10s %-10d\n", Hsno, Hsname, Hssex, HSage);/* 询问用户是否要更新该学生的年龄 */printf("UPDATE AGE(y/n)? ");do {scanf("%c", &yn);-- getchar(); --吃掉多余的换行符} while (yn != 'N' && yn != 'n' && yn != 'Y' && yn != 'y');-- 强制让用户必须输入 Y/y/ N/n 才往下走,输错就一直重新输/* 如果选择更新操作 */if (yn == 'y' || yn == 'Y') {printf("INPUT NEW AGE: ");scanf("%d", &NEWAGE);getchar();/* 嵌入式SQL更新语句*/EXEC SQL UPDATE StudentSET Sage = :NEWAGE -- Sage更新为读入的NWEAGEWHERE CURRENT OF SX;} /* 对当前游标指向的学生年龄进行更新 */}/* 收尾 */EXEC SQL CLOSE SX; -- 关闭游标SX,不再和查询结果对应EXEC SQL COMMIT WORK; -- 提交更新EXEC SQL DISCONNECT TEST; -- 断开数据库连接} -- 只在 EXEC SQL FETCH SX INTO 语句之后检查了状态码 SQLCA.SQLCODE-- 在其他嵌入式SQL语句之后,都没有检查SQL语句的执行状态码!-- Solution:添加异常处理👇
异常处理
whenever是嵌入式SQL的全局异常捕获机制预编译器在处理过程中,会根据WHENEVER语句的定义,在每一条嵌入式SQL语句之后添加下面的异常状态检查命令:EXEC SQL WHENEVER 条件 动作;if ( condition ) { action }- 常见执行异常
SQLERROR、NOT FOUND、SQLWARNING - 处理方法 CONTINUE、GOTO、STOP、DO function | BREAK | CONTINUE
- 例
exec sql whenever sqlerror goto report_error ;exec sql whenever not found goto notfound ;
不用游标的SQL语句
- 说明性语句、数据定义 / 控制语句
-- 1. 主变量声明(必须用固定段包裹)EXEC SQL BEGIN DECLARE SECTION;char givensno[10];char hsno[10], hsname[21];EXEC SQL END DECLARE SECTION;-- 2. 定义SQL通信区(获取SQL执行状态)EXEC SQL INCLUDE SQLCA;-- 3. 异常处理声明(出错跳转、无数据跳转)EXEC SQL WHENEVER SQLERROR GOTO error_handle;EXEC SQL WHENEVER NOT FOUND GOTO no_ data;-- 创建学生表 CREATEEXEC SQL CREATE TABLE Student (Sno CHAR(9) PRIMARY KEY,Sname CHAR(20) NOT NULL,Sage SMALLINT,Sdept CHAR(20));--删除表DROPEXEC SQL DROP TABLE TEST;-- 修改ALTER:为Student表添加手机号字段EXEC SQL ALTER TABLE Student ADD Sphone CHAR(11);-- 授权:给用户user1授予Student表的查询、修改权限EXEC SQL GRANT SELECT, UPDATE ON Student TO user1;-- 回收user1对Student表的修改权限EXEC SQL REVOKE UPDATE ON Student FROM user1;-- 事务控制:提交数据库更新(如增删改)EXEC SQL COMMIT WORK;
- 单条结果查询:SELECT … INTO …
EXEC SQL SELECT Sno,Cno,GradeINTO :Hsno, :Hname, :Hcno, :Hgrade, :Gradeid /* 指示变量Gradeid */FROM SCWHERE Sno = :givensno AND Cno = :givencno;if(Gradeid < 0){…… -- 学生givensno在课程givencno上的成绩为空值}else{……}
- 普通增删改(非 CURRENT 形式的 INSERT、DELETE、UPDATE)
增:某个学生新选修了某门课程,将有关记录插入SC表中。假设插入的学号已赋给主变量stdno,课程号已赋给主变量couno。gradeid = −1; /* gradeid为指示变量 */EXEC SQL INSERTINTO SC(Sno, Cno, Grade)VALUES(:stdno, :couno, :gr :gradeid);
使用游标的SQL语句
- 使用语句多条结果的 SELECT 查询、CURRENT 形式的 UPDATE/DELETE 语句
- 游标(Cursor)的使用操作
- 声明游标
EXEC SQL DECLARE 游标名 CURSOR FOR 查询语句; - 打开游标
EXEC SQL OPEN 游标名; - 提取数据
EXEC SQL FETCH 游标名 INTO 主变量; - 关闭游标
EXEC SQL CLOSE 游标名;
- 声明游标
- 可滚动游标 SCROLL
-- 加SCROLLEXEC SQL DECLARE agent_dollars SCROLL CURSOR FORSELECT aid, sum(dollars)FROM ordersWHERE cid = :cust_idGROUP BY aid;EXEC SQL OPEN agent_dollars;EXEC SQL FETCH FIRST agent_dollars INTO :agent_id,:dollar_sum;EXEC SQL FETCH LAST agent_dollars INTO :agent_id,:dollar_sum;EXEC SQL FETCH PRIOR agent_dollars INTO :agent_id,:dollar_sum; -- 上一个EXEC SQL FETCH NEXT agent_dollars INTO :agent_id,:dollar_sum; -- 下一个
- 例
EXEC SQL INCLUDE SQLCA; --定义SQL状态区-- 声明主变量EXEC SQL BEGIN DECLARE SECTION;char cust_id[10];char agent_id[10];float dollar_sum;EXEC SQL END DECLARE SECTION;-- 声明异常处理(必须写在最前面!)EXEC SQL WHENEVER NOT FOUND GOTO finish;/* 声明游标 agent_dollars */EXEC SQL DECLARE agent_dollars CURSOR FORSELECT aid,sum(dollars)FROM ordersWHERE cid=:cust_idGROUP BY aid;/* 打开游标 */EXEC SQL OPEN agent_dollars;/* 提取数据 */while (TRUE) {EXEC SQL FETCH agent_dollars INTO :agent_id, :dollar_sum;-- 推动游标指针至下一条记录,同时将当前记录取出来送至主变量printf("%s %11.2f\n", agent_id, dollar_sum);}/* 关闭游标 */finish: EXEC SQL CLOSE agent_dollars;
-
CURRENT 形式的 UPDATE/DELETE 语句
需要对查询结果集做差异化修改(如有的行改、有的不改、有的改的数值不同),而不是批量UPDATE/DELETE
WHERE CURRENT OF 游标名
EXEC SQL DECLARE SX CURSOR FOR SELECT Sno,Sname,Ssex,Sage FROM Student WHERE Sdept=:deptname;EXEC SQL OPEN SX;for(;;){ EXEC SQL FETCH SX INTO :HSno,:Hname,:HSsex,:HSage; if (SQLCA.SQLCODE != 0) break; -- 操作不成功,则退出循环 …… EXEC SQL UPDATE Student SET Sage=:NEWAGE WHERE CURRENT OF SX; -- 只对当前游标指向的一行记录 ……}EXEC SQL CLOSE SX;动态SQL
- 使用SQL语句主变量
程序主变量包含的内容是SQL语句的内容**EXEC SQL BEGIN DECLARE SECTION;const char *stmt = "CREATE TABLE test(a int);";-- 定义了一个字符串指针变量stmt,内容是一条完整的 SQL 语句文本-- CREATE TABLE test(a int);(功能是创建一张名为test的表,包含一个int类型的列a)const char *stmt = "CREATE TABLE student(sno char(9), sname char(20));";-- 或者这么写EXEC SQL END DECLARE SECTION;/* 执行动态SQL语句,可以动态创建TABLE */EXEC SQL EXECUTE IMMEDIATE :stmt; - 动态参数
用?当占位符 - 执行准备好的语句(EXECUTE)
EXEC SQL BEGIN DECLARE SECTION;const char *stmt="INSERT INTO test VALUES(?);";-- 动态参数EXEC SQL END DECLARE SECTION;/* 准备语句 */EXEC SQL PREPARE mystmt FROM :stmt;/*执行INSERT语句,设定参数为100*/EXEC SQL EXECUTE mystmt USING 100;
过程化SQL
- what?写在数据库中的带编程逻辑的SQL语言,可用于定义触发器、存储过程、存储函数对应的SQL程序块。
- 过程化SQL vs 嵌入式SQL
可独立编程,不再需要区分 主变量 与 SQL变量
不需要经历从预编译到编译的处理
在数据库服务器内部实现数据交换与处理 - 常用的两种过程化SQL:Oracle:PL/SQL;SQL Server:T-SQL
过程化SQL的块结构
- 过程化SQL的基本单位是块 Block
- 块结构拆解
- 定义部分(DECLARE)
声明局部变量、常量、游标、自定义异常
DECLAREv_sname CHAR(20); -- 变量v_age CONSTANT INT := 18; -- 常量CURSOR c_stu IS SELECT Sname FROM Student; -- 游标e_age_too_old EXCEPTION; -- 自定义异常- 执行部分(BEGIN…END)
BEGIN-- 正常执行的逻辑SELECT Sname INTO v_sname FROM Student WHERE Sno = '241880543';IF v_age > 30 THENRAISE e_age_too_old; -- 抛出自定义异常END IF;EXCEPTIONWHEN NO_DATA_FOUND THENDBMS_OUTPUT.PUT_LINE('未找到该学生!');WHEN e_age_too_old THENDBMS_OUTPUT.PUT_LINE('年龄超过限制!');WHEN OTHERS THENDBMS_OUTPUT.PUT_LINE('发生未知错误:' || SQLERRM);END; - 定义部分(DECLARE)
PL/SQL变量和常量的定义
- 变量定义
- 基本数据结构 Number、Char、Date、Long、Boolean、Varchar2
- 注意:
char h_sno[10] = "211210166"; // 对应 char(9),需 n+1 长度
- 例
DECLARE-- ① 无初值、允许为NULL(PPT里的基础形式)v_name VARCHAR2(20); -- 变长字符型,最大为4000个字符/Char 字符型,最大2000个字符-- ② 带NOT NULL + 用:=赋值(语法1,严格按PPT)v_age NUMBER(3) NOT NULL := 18;-- ③ 带NOT NULL + 用DEFAULT赋值(等价于PPT的语法2,效果和:=完全一致)v_score NUMBER NOT NULL DEFAULT 60;BEGIN-- 赋值语句v_name := '张三';END; - 常量定义